Bao nhiêu cảnh báo là quá nhiều? Alert fatigue và cách đặt ngưỡng cho đúng
Có một nghịch lý trong vận hành bot mà bạn chỉ nhận ra sau khi đã trải qua: thêm cảnh báo có thể làm hệ thống của bạn kém an toàn hơn. Không phải vì cảnh báo sai, mà vì cảnh báo nhiều.
Cơ chế rất đơn giản. Tuần đầu, bạn nhận 5 tin nhắn. Bạn đọc hết, xử lý hết. Tuần thứ hai, bạn nhận 40 tin — trong đó 35 tin là báo động giả vì ngưỡng đặt quá sát. Bạn bắt đầu đọc lướt. Tuần thứ tư, bạn nhận 200 tin. Bạn bắt đầu đọc tiêu đề rồi bỏ qua. Đến lúc đó, bạn đã tự vô hiệu hoá hệ thống cảnh báo của mình — và tệ hơn, bạn vẫn tin rằng mình đang được bảo vệ.
Bài này nói về việc thiết kế cảnh báo sao cho nó còn giá trị sau sáu tháng, chứ không chỉ trong tuần đầu. Phần đầu là vòng xoáy nhờn cảnh báo và cách nó bắt đầu từ một quyết định hoàn toàn hợp lý. Phần giữa là bốn mức cảnh báo, năm nguyên nhân báo động giả và cách sửa từng cái, cùng bảng ngưỡng gợi ý để bạn bắt đầu. Phần sau là cooldown, leo thang, cách kiểm tra kênh cảnh báo, và cách đo chất lượng cảnh báo bằng tỉ lệ nhiễu.
1. Nghịch lý: thêm cảnh báo có thể làm bạn kém an toàn hơn
Hãy bắt đầu từ trực giác: cảnh báo là tốt, nên nhiều cảnh báo là tốt hơn. Trực giác này sai, vì nó bỏ qua một biến số: khả năng chú ý của bạn là hữu hạn và không tăng theo số cảnh báo.
Nếu bạn có 10 cảnh báo mỗi tuần và tất cả đều là sự cố thật, bạn sẽ đọc từng cái với sự chú ý đầy đủ. Nếu bạn có 500 cảnh báo mỗi tuần và 5 trong số đó là thật, bạn sẽ không thể duy trì sự chú ý đó — và bạn sẽ bỏ lỡ những cái thật. Không phải vì bạn lười, mà vì đó là giới hạn của con người khi đối mặt với tín hiệu có tỉ lệ nhiễu cao.
Điều này có một hệ quả quan trọng và ít được nhận ra: một cảnh báo giả không chỉ vô dụng — nó có chi phí âm. Nó tiêu tốn sự chú ý mà bạn cần dành cho cảnh báo thật. Nói cách khác, mỗi cảnh báo giả bạn thêm vào làm giảm độ nhạy của toàn bộ hệ thống, không chỉ làm bạn khó chịu.
Và có một điểm cuối cùng, nguy hiểm nhất: khi cảnh báo giả trở nên quá nhiều, phản ứng tự nhiên không phải là sửa ngưỡng — mà là tắt cảnh báo. Bạn tắt thông báo Telegram lúc đêm, hoặc tắt hẳn một loại cảnh báo. Lúc đó, hệ thống cảnh báo của bạn không còn tồn tại — nhưng bạn vẫn cảm thấy mình "có hệ thống giám sát". Đây là trạng thái tệ nhất có thể: nguy hiểm hơn cả việc không có cảnh báo, vì bạn không biết mình đang không được bảo vệ.
2. Vòng xoáy nhờn cảnh báo
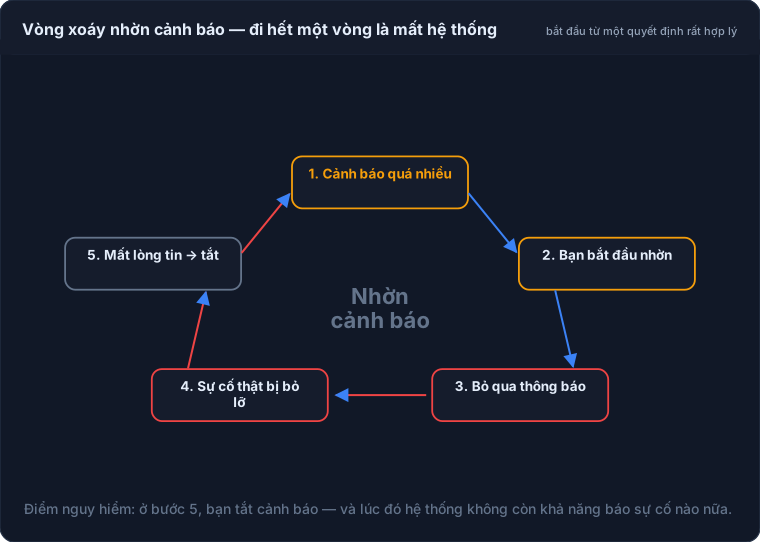
Năm bước của vòng xoáy này đáng xem kỹ, vì mỗi bước đều là một quyết định hợp lý tại thời điểm đó.
Bước 1 — Cảnh báo quá nhiều. Bạn vừa dựng xong hệ thống giám sát. Để chắc chắn không bỏ sót gì, bạn bật mọi cảnh báo với ngưỡng khá sát. Đây là quyết định hợp lý: thà báo nhiều còn hơn bỏ sót.
Bước 2 — Bạn bắt đầu nhờn. Sau một tuần với hàng trăm tin, bạn bắt đầu phân loại trong đầu: "tin này chắc lại là báo động giả". Đây cũng là phản ứng hợp lý — não bạn đang tối ưu hoá việc dùng sự chú ý.
Bước 3 — Bỏ qua thông báo. Bạn không tắt cảnh báo, bạn chỉ đọc lướt. Nghe có vẻ vẫn ổn: bạn vẫn "có xem". Thực tế là không — đọc lướt 200 tin tương đương không đọc tin nào.
Bước 4 — Sự cố thật bị bỏ lỡ. Xác suất này không nhỏ, nó là hệ quả tất yếu của bước 3. Tin về sự cố thật trông giống hệt 199 tin trước đó.
Bước 5 — Mất lòng tin và tắt. Sau một sự cố bị bỏ lỡ, bạn kết luận hệ thống cảnh báo "không hoạt động" và tắt nó đi. Đây là bước tệ nhất, và nó xảy ra phổ biến hơn bạn nghĩ.
Điểm mấu chốt của vòng xoáy này: nó bắt đầu từ một quyết định đúng. Bạn không sai khi muốn báo nhiều. Bạn chỉ thiếu một bước: đo lường và chỉnh lại theo dữ liệu. Người thoát được vòng xoáy không phải người đặt ngưỡng đúng ngay từ đầu — mà là người chịu khó đo số lần báo trong tuần đầu và chỉnh lại.
3. Bốn mức cảnh báo và kênh tương ứng
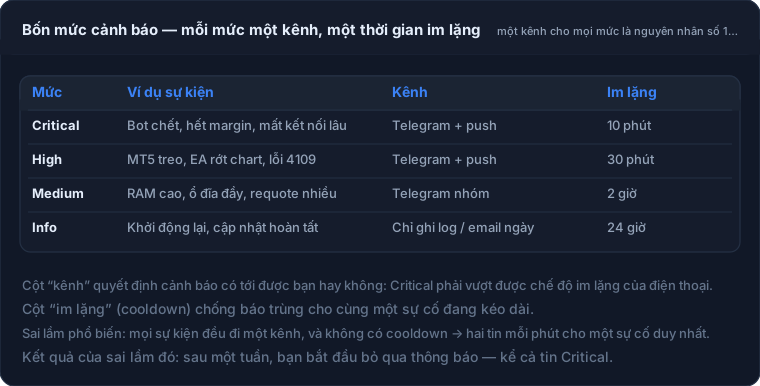
Nguyên nhân số một của nhờn cảnh báo là: mọi sự kiện đều đi qua cùng một kênh. Bot chết và "MT5 vừa khởi động lại" đều gửi vào cùng một nhóm Telegram — và sau một tuần bạn sẽ không phân biệt được chúng nữa.
Cách sửa là tách bốn mức, mỗi mức một kênh và một thời gian im lặng (cooldown) riêng.
Critical — cần bạn hành động ngay. Ví dụ: bot chết hoàn toàn (không có nhịp heartbeat), hết margin, mất kết nối lâu, VPS không phản hồi. Kênh: thông báo đẩy trên điện thoại (push) và Telegram. Thời gian im lặng: 10 phút.
Điều quan trọng với mức này: nó phải vượt được chế độ im lặng của điện thoại. Nếu bạn để chế độ Do Not Disturb ban đêm, một cảnh báo Critical lúc 3 giờ sáng sẽ nằm im tới 7 giờ — và bạn đã mất bốn tiếng. Đây là điểm mà nhiều hệ thống giám sát đúng về mặt kỹ thuật nhưng vô dụng về mặt vận hành.
High — cần xử lý trong ngày. Ví dụ: MT5 treo, EA rớt chart, lỗi 4109 lặp lại. Kênh: push + Telegram. Thời gian im lặng: 30 phút.
Medium — cần biết, xử lý khi thuận tiện. Ví dụ: RAM cao, ổ đĩa trên 80%, requote nhiều. Kênh: một nhóm Telegram riêng (không phải thông báo đẩy trên điện thoại). Thời gian im lặng: 2 giờ.
Info — chỉ để tra cứu. Ví dụ: MT5 khởi động lại, cấu hình được nạp thành công, cập nhật hoàn tất. Kênh: chỉ ghi vào log hoặc email tổng hợp hằng ngày. Thời gian im lặng: 24 giờ.
Việc tách kênh theo mức có hai hiệu quả: bạn chỉ bị đánh thức bởi những thứ thật sự cần đánh thức bạn, và bạn vẫn có dữ liệu đầy đủ trong email tổng hợp hằng ngày để biết chuyện gì đã xảy ra. Không có thông tin nào bị mất — chỉ có sự chú ý của bạn được phân bổ đúng.
4. Năm nguyên nhân báo động giả và cách sửa
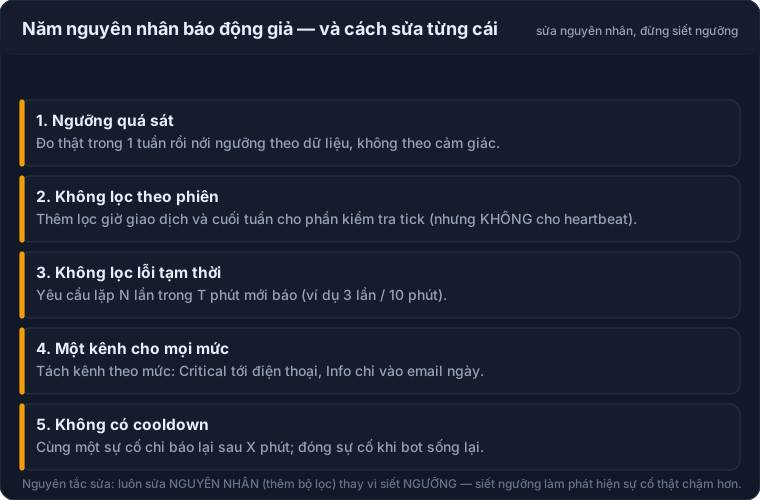
Nguyên nhân 1 — Ngưỡng quá sát. Bạn đặt ngưỡng 30 giây vì "30 giây là đủ lâu để coi là chết". Nhưng terminal bận có thể trễ OnTimer vài giây, và mạng có thể trễ vài giây. Cách sửa: đo thật trong một tuần — ghi lại phân bố thời gian giữa các nhịp heartbeat — rồi đặt ngưỡng ở mức mà 99% trường hợp bình thường không vượt qua.
Nguyên nhân 2 — Không lọc theo phiên. Cuối tuần và ngoài giờ giao dịch không có tick. Nếu bạn kiểm tra tick không có bộ lọc phiên, mỗi cuối tuần bạn sẽ nhận một chuỗi cảnh báo. Cách sửa: thêm lọc giờ giao dịch cho phần kiểm tra tick — nhưng không thêm lọc cho phần kiểm tra heartbeat, vì EA phải sống kể cả cuối tuần.
Nguyên nhân 3 — Không lọc lỗi tạm thời. Một lần requote (mã 138) là bình thường và không cần báo. Cách sửa: yêu cầu lặp N lần trong T phút mới báo — ví dụ ba lần trong mười phút. Với lỗi thuộc loại "có thể xảy ra đơn lẻ", hãy yêu cầu lặp; với lỗi thuộc loại "chỉ xảy ra khi có vấn đề", báo ngay từ lần đầu.
Nguyên nhân 4 — Một kênh cho mọi mức. Đã bàn ở mục 3. Đây là nguyên nhân phổ biến nhất và cũng dễ sửa nhất: chỉ cần tạo thêm một nhóm Telegram.
Nguyên nhân 5 — Không có cooldown. Một sự cố kéo dài hai giờ có thể sinh ra hàng trăm cảnh báo nếu bạn kiểm tra mỗi 30 giây và báo mỗi lần thất bại. Cách sửa: cooldown — cùng một sự cố chỉ báo lại sau X phút. Chi tiết ở mục 7.
Một nguyên tắc chung khi sửa cả năm nguyên nhân này: luôn sửa nguyên nhân (thêm bộ lọc), đừng siết ngưỡng. Siết ngưỡng làm giảm số lần báo nhưng đồng thời làm bạn phát hiện sự cố thật chậm hơn — bạn đánh đổi độ nhạy để lấy sự yên tĩnh. Thêm bộ lọc làm bạn phát hiện đúng hơn mà không mất độ nhạy. Hai việc này khác nhau về bản chất, dù cả hai đều làm số tin nhắn giảm.
5. Bảng ngưỡng gợi ý
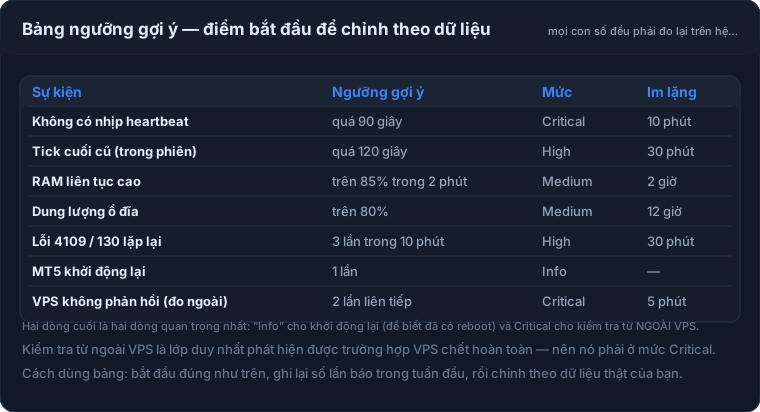
Đây là điểm bắt đầu, không phải điểm kết thúc. Mọi con số đều phải được đo lại trên hệ thống của bạn.
| Sự kiện | Ngưỡng gợi ý | Mức | Im lặng |
|---|---|---|---|
| Không có nhịp heartbeat | quá 90 giây | Critical | 10 phút |
| Tick cuối cũ (trong phiên) | quá 120 giây | High | 30 phút |
| RAM liên tục cao | trên 85% trong 2 phút | Medium | 2 giờ |
| Dung lượng ổ đĩa | trên 80% | Medium | 12 giờ |
| Lỗi 4109 / 130 lặp lại | 3 lần trong 10 phút | High | 30 phút |
| MT5 khởi động lại | 1 lần | Info | — |
| VPS không phản hồi (đo ngoài) | 2 lần liên tiếp | Critical | 5 phút |
Hai dòng cuối đáng nói riêng:
"MT5 khởi động lại" ở mức Info. Nghe có vẻ không quan trọng, nhưng đây là dòng cho bạn biết đã có reboot. Nếu bạn thấy nó xuất hiện trong email tổng hợp ba lần một tuần, bạn biết mình có vấn đề ở tầng máy — dù không có lỗi nào khác được báo. Đặt ở mức Info là đúng: bạn cần biết, nhưng không cần bị đánh thức.
"VPS không phản hồi" ở mức Critical. Đây là lớp kiểm tra từ bên ngoài VPS, và là lớp duy nhất phát hiện được trường hợp VPS chết hoàn toàn. Nếu VPS chết, mọi cảnh báo sinh ra từ trong VPS cũng chết theo — nên cảnh báo duy nhất bạn có thể nhận được phải đến từ bên ngoài. Vì thế nó phải ở mức Critical.
Một lưu ý về đơn vị thời gian: hãy dùng một đơn vị duy nhất trong toàn bộ cấu hình. Trộn "giây" ở chỗ này và "phút" ở chỗ khác là nguồn lỗi rất phổ biến — và nó là loại lỗi không phát hiện được cho tới khi có sự cố thật.
6. Nguyên tắc: một cảnh báo = một hành động
Đây là nguyên tắc quan trọng nhất khi thiết kế nội dung cảnh báo:
Mỗi cảnh báo phải trả lời được câu hỏi: "tôi nên làm gì ngay bây giờ?"
Nếu bạn không trả lời được, cảnh báo đó chưa hoàn chỉnh. Và nếu câu trả lời là "không cần làm gì", cảnh báo đó nên bị hạ xuống mức Info hoặc bỏ hẳn.
Hãy so sánh hai cảnh báo:
Cảnh báo kém: "Cảnh báo: VPS-A có vấn đề."
Người nhận không biết phải làm gì. Họ phải mở RDP, kiểm tra mọi thứ, rồi tự tìm ra. Toàn bộ giá trị của việc phát hiện tự động bị mất trong bước tiếp theo.
Cảnh báo tốt:
🔴 Tài khoản 3456789 (live) — bot đã dừng
Máy      : VPS-B
EA       : BotGold v1.0.4
Nhịp cuối: 03:07:12 (cũ 4.812 giây)
Tick cuối: 03:07:10
Lệnh đang mở: 2
RAM      : 91%   Ổ đĩa: 78%
Việc cần làm: kiểm tra RAM; CÓ 2 LỆNH MỞ nên cần xử lý cẩn thận
Người nhận biết ngay: tài khoản nào, máy nào, bot nào, đã dừng bao lâu, có lệnh đang mở hay không, và hành động nào nên làm trước. Đây là cảnh báo mà bạn không phải mở RDP để hành động.
Bốn thành phần bắt buộc của một cảnh báo hành động được:
- Danh tính cụ thể: tài khoản nào, máy nào, EA nào. Không phải "có vấn đề" mà là "tài khoản 3456789 trên VPS-B".
- Số đo: cũ bao nhiêu giây, ở mức bao nhiêu phần trăm. Đừng chỉ nói "quá ngưỡng" — nói vượt bao nhiêu.
- Ngữ cảnh quyết định: số lệnh đang mở là trường quan trọng nhất, vì nó quyết định bạn có thể tự khởi động lại hay không.
- Gợi ý hành động: một dòng ngắn nói nên làm gì trước.
7. Cooldown và chống trùng: cách làm đúng
Cooldown là khoảng thời gian tối thiểu giữa hai cảnh báo cho cùng một sự cố. Không có nó, một sự cố kéo dài sẽ sinh ra cảnh báo mỗi chu kỳ kiểm tra.
Cách làm sai:
- Gửi mỗi lần kiểm tra thất bại. Kiểm tra 30 giây một lần, gửi 30 giây một lần. Một sự cố hai giờ = 240 tin nhắn.
- Gửi một lần rồi không bao giờ gửi lại. Nếu bạn bỏ lỡ tin đầu tiên (đang ngủ, điện thoại hết pin), bạn sẽ không biết gì cho tới khi tự kiểm tra. Đây là sai lầm ở thái cực ngược lại và cũng nguy hiểm không kém.
- Cooldown theo đồng hồ tuyệt đối. Ví dụ chỉ gửi cảnh báo vào các phút chia hết cho 10. Cách này làm cảnh báo xuất hiện ở những mốc thời gian không liên quan gì tới sự cố.
Cách làm đúng — cooldown theo trạng thái (state machine):
Hệ thống của bạn cần theo dõi trạng thái của từng tài khoản, không chỉ trạng thái hiện tại. Có ba trạng thái: OK, ĐANG CÓ SỰ CỐ (đã báo), và ĐÃ PHỤC HỒI.
Luật đơn giản:
- OK → sự cố: gửi cảnh báo ngay (không chờ cooldown). Đây là lúc bạn cần biết nhất.
- Đang có sự cố → vẫn sự cố: không gửi lại, trừ khi đã qua cooldown và sự cố đã leo thang (ví dụ thời gian chết tăng gấp ba).
- Đang có sự cố → OK: gửi tin "đã phục hồi". Đây là tin cần thiết, vì nó cho bạn biết hệ thống tự hồi phục được — và cho bạn dữ liệu để tính MTTR.
- Sự cố → vẫn OK: không làm gì.
Điểm quan trọng nhất là luật 1 và 3. Không chờ cooldown cho cảnh báo đầu tiên — cooldown chỉ để chống lặp lại, không được làm chậm phát hiện. Và luôn gửi tin phục hồi — nhiều hệ thống quên điều này, khiến bạn không biết sự cố đã kết thúc hay chưa, và phải tự kiểm tra.
Một lưu ý về cách lưu trạng thái: trạng thái này phải được lưu ở nơi tồn tại qua các lần chạy (một file JSON, hoặc một hàng trong database). Nếu bạn lưu trong bộ nhớ của tiến trình và tiến trình khởi động lại, bạn sẽ mất trạng thái và gửi một loạt cảnh báo trùng ngay sau khi restart.
8. Leo thang (escalation): khi nào và thế nào
Cooldown giải quyết việc chống trùng, nhưng có một tình huống nó không giải quyết: sự cố kéo dài mà bạn không phản hồi. Bạn đang ngủ, điện thoại im lặng, hoặc bạn đang ở nơi không có mạng.
Leo thang là cơ chế xử lý tình huống đó. Cách thiết kế:
Mức 1 (0 phút): gửi cảnh báo bình thường qua kênh đã cấu hình.
Mức 2 (sau 15 phút, nếu chưa được xác nhận): gửi lại qua kênh mạnh hơn — ví dụ gọi điện thay vì tin nhắn, hoặc gửi vào một nhóm có người khác.
Mức 3 (sau 30 phút): gửi tới người thứ hai (đồng nghiệp, hoặc thành viên gia đình biết bạn đang chạy bot), hoặc thực hiện hành động tự phục hồi nếu an toàn.
Mức 4 (sau 60 phút): ghi lại sự cố vào file "cần xử lý khi thức dậy" và dừng leo thang. Đây là điểm dừng quan trọng — nếu không có nó, hệ thống sẽ gọi bạn 50 lần trong một đêm, và bạn sẽ tắt nó.
Ba điều cần lưu ý về leo thang:
Phải có cách "xác nhận". Nếu không có cơ chế xác nhận (ví dụ một nút hoặc một tin nhắn trả lời), hệ thống không biết bạn đã thấy cảnh báo hay chưa, và sẽ leo thang dù bạn đã xử lý xong. Với hệ thống đơn giản, bạn có thể dùng chính việc "sự cố đã hết" làm dấu hiệu xác nhận.
Phải có điểm dừng. Không có giới hạn, hệ thống leo thang vô hạn — và đó là cách nhanh nhất để bạn tắt nó.
Nên phân biệt theo mức sự cố. Chỉ mức Critical mới leo thang tới gọi điện. Nếu mức High cũng gọi điện, bạn sẽ tắt tính năng này trong tuần đầu.
9. Kiểm tra kênh cảnh báo: dùng sự vắng mặt làm tín hiệu
Một hệ thống cảnh báo có thể hỏng ở ba chỗ: logic phát hiện, tiến trình gửi, và kênh gửi. Hai chỗ đầu bạn thường chú ý; chỗ thứ ba thì hay bị bỏ qua. Token Telegram hết hạn, bot bị chặn, số điện thoại đổi — trong mọi trường hợp, cảnh báo không tới được bạn và bạn không biết.
Cách kiểm tra hiệu quả nhất dùng sự vắng mặt của thông tin làm tín hiệu:
Cách 1 — Cảnh báo "vẫn sống" theo lịch. Mỗi sáng vào một giờ cố định, hệ thống gửi một tin ngắn: "Hệ thống giám sát hoạt động bình thường — 5 tài khoản, 0 sự cố." Nếu bạn không nhận được tin đó vào một ngày có giao dịch, bạn biết có vấn đề ở kênh hoặc ở hệ thống. Đây là mẹo rất hiệu quả vì nó biến một việc "không có gì xảy ra" thành một tín hiệu tích cực.
Cách 2 — Cảnh báo thử theo lịch tuần. Mỗi Chủ nhật (khi thị trường đóng, sự cố thật khó xảy ra), hệ thống gửi một cảnh báo giả với định dạng giống cảnh báo thật. Nếu nó tới và hiển thị đúng, kênh còn hoạt động. Đây là cách kiểm tra cả định dạng chứ không chỉ kênh.
Cách 3 — Kiểm tra hai chiều. Với cảnh báo ở mức Critical, hãy yêu cầu xác nhận: hệ thống gửi, chờ một phản hồi, và nếu không có phản hồi trong 15 phút thì coi như cảnh báo không tới được người. Cách này phức tạp hơn hai cách trên nhưng là cách duy nhất phát hiện được trường hợp "tin nhắn được gửi thành công nhưng người nhận không thấy" — ví dụ tin bị chặn ở tầng thiết bị.
Và một chi tiết thực dụng: hãy tự thử kênh cảnh báo trước khi dựa vào nó. Tắt MT5 theo cách thô, rồi ngồi đợi xem cảnh báo có tới trong 60 giây hay không. Nếu không tới, bạn đã phát hiện ra một vấn đề quan trọng vào lúc an toàn, thay vì phát hiện ra trong một đêm bot chết.
10. Đo chất lượng cảnh báo: tỉ lệ nhiễu
Cách duy nhất để biết hệ thống cảnh báo của bạn có còn giá trị là đo nó. Và chỉ số cần đo có tên: tỉ lệ nhiễu (noise ratio).
Công thức: tỉ lệ nhiễu = số cảnh báo giả ÷ tổng số cảnh báo, tính theo tuần.
Ngưỡng thực dụng:
| Tỉ lệ nhiễu | Đánh giá | Việc cần làm |
|---|---|---|
| dưới 10% | Tốt | Giữ nguyên, xem lại mỗi tháng |
| 10–30% | Chấp nhận được | Xem lại ngưỡng của loại cảnh báo nhiều nhất |
| 30–50% | Có vấn đề | Bạn sẽ bắt đầu bỏ qua cảnh báo trong vài tuần tới |
| trên 50% | Hệ thống đã mất giá trị | Hệ thống cảnh báo này không còn bảo vệ bạn |
Cách đo: mỗi tuần, đếm tổng số cảnh báo và số cảnh báo mà khi kiểm tra bạn kết luận là "không phải sự cố". Nếu bạn không ghi lại, hãy ước lượng theo trí nhớ — nhưng hãy làm ngay trong tuần này, vì ước lượng theo trí nhớ chỉ chính xác khi bạn còn nhớ.
Hai chỉ số bổ sung đáng theo dõi:
Số cảnh báo mỗi ngày. Nếu con số này tăng dần theo thời gian mà hệ thống không thay đổi, đó là dấu hiệu bạn đang thêm ngưỡng mà không dọn ngưỡng cũ. Một hệ thống lành mạnh có số cảnh báo ổn định hoặc giảm.
Thời gian phản hồi trung bình của bạn. Từ lúc cảnh báo tới lúc bạn kiểm tra. Nếu con số này tăng dần, bạn đang nhờn. Đây là chỉ số về chính bạn, và nó là dấu hiệu sớm nhất của vòng xoáy ở mục 2.
11. Lộ trình 4 tuần: từ không cảnh báo tới cảnh báo đáng tin
Nếu bạn đang bắt đầu từ con số không, đây là lộ trình để không rơi vào vòng xoáy.
Tuần 1 — Chỉ bật một cảnh báo. Cảnh báo duy nhất: không có nhịp heartbeat quá 90 giây, mức Critical. Không thêm gì khác. Mục đích không phải là giám sát đầy đủ, mà là đo xem kênh cảnh báo có hoạt động hay không và xem nó có gây báo động giả trong điều kiện bình thường.
Tuần 2 — Ghi lại mọi lần báo và phân loại. Với mỗi cảnh báo trong tuần, ghi lại: thời điểm, sự cố thật hay giả, và nếu là giả thì lý do. Sau một tuần, bạn sẽ biết ngưỡng của mình có đúng không — bằng dữ liệu, không bằng cảm giác.
Tuần 3 — Thêm cảnh báo thứ hai và thứ ba. Chọn những cảnh báo có giá trị rõ ràng: tick cuối cũ trong phiên (High), và kiểm tra từ ngoài VPS (Critical). Đây là lúc bạn tách kênh: Critical đi push và Telegram, High đi Telegram.
Tuần 4 — Đo tỉ lệ nhiễu và chỉnh. Tính tỉ lệ nhiễu của ba tuần vừa qua. Nếu trên 30%, hãy sửa nguyên nhân theo bảng ở mục 4 — không siết ngưỡng. Sau đó thêm các cảnh báo Medium và Info, mỗi loại vào đúng kênh của nó.
Lộ trình này chậm, và đó là điểm mạnh của nó: bạn thêm từng cảnh báo, đo tác động của nó, rồi mới thêm cái tiếp theo. Cách làm ngược lại — bật 20 cảnh báo cùng lúc ở ngưỡng sát — gần như chắc chắn dẫn tới vòng xoáy ở mục 2.
Một lưu ý cho giai đoạn sau: đừng bao giờ bật nhiều cảnh báo mới cùng lúc trước một kỳ nghỉ hoặc một tuần bạn biết mình bận. Đó là lúc bạn không có thời gian phân loại nhiễu, và tỉ lệ nhiễu sẽ tăng mà bạn không biết.
12. Checklist và tóm lại
Checklist 12 điểm cho hệ thống cảnh báo:
- Cảnh báo được tách theo bốn mức: Critical / High / Medium / Info
- Mỗi mức có kênh riêng; Critical vượt được chế độ im lặng của điện thoại
- Mỗi mức có thời gian im lặng (cooldown) riêng
- Không chờ cooldown cho cảnh báo đầu tiên của một sự cố
- Luôn gửi tin phục hồi khi sự cố kết thúc
- Có bộ lọc phiên cho kiểm tra tick, nhưng không lọc cho heartbeat
- Lỗi có thể xảy ra đơn lẻ (như requote) yêu cầu lặp N lần mới báo
- Mỗi cảnh báo có danh tính cụ thể: tài khoản, máy, EA
- Mỗi cảnh báo có số đo và số lệnh đang mở
- Mỗi cảnh báo có một dòng gợi ý hành động
- Có cảnh báo "vẫn sống" theo lịch để kiểm tra kênh
- Đang đo tỉ lệ nhiễu mỗi tuần và giữ dưới 10%
Bốn ý cần nhớ:
- Một cảnh báo giả có chi phí âm. Nó không chỉ vô dụng — nó tiêu tốn sự chú ý mà bạn cần cho cảnh báo thật.
- Sửa nguyên nhân, đừng siết ngưỡng. Siết ngưỡng đánh đổi độ nhạy để lấy sự yên tĩnh; thêm bộ lọc cho bạn cả hai.
- Mỗi cảnh báo phải trả lời: "tôi nên làm gì ngay bây giờ?" Nếu không trả lời được, hạ mức hoặc bỏ.
- Đo tỉ lệ nhiễu mỗi tuần. Đó là chỉ số duy nhất cho biết hệ thống cảnh báo của bạn còn giá trị hay đã trở thành tiếng ồn.
Đây là bài cuối của loạt bài về vận hành bot. Nếu bạn mới bắt đầu, hãy đọc theo thứ tự: Bot chết lúc 3h sáng: 12 nguyên nhân thật để biết cần bắt những gì, EA Watchdog để có cơ chế phát hiện, Đọc log MT5 để chẩn đoán khi có sự cố, và bài này để đảm bảo cảnh báo của bạn vẫn còn giá trị sau sáu tháng.
Một hệ thống cảnh báo tốt không phải hệ thống báo nhiều nhất. Nó là hệ thống mà mỗi lần báo, bạn tin ngay.