Đo uptime bot cho đúng: MTBF, MTTR, Availability và chi phí mỗi giờ downtime
Hỏi một trader chạy bot "hệ thống của bạn uptime bao nhiêu?" và bạn sẽ nhận được một con số. Vấn đề là con số đó thường không đo cái họ nghĩ nó đo.
"Uptime 99,9%" — đo cái gì? Nếu là thời gian VPS bật, thì một đêm MT5 treo bốn tiếng vẫn cho bạn 99,9%, vì máy vẫn bật. Nếu là "có tiến trình terminal64.exe", thì bạn đang đo sự tồn tại, không đo hoạt động. Nếu là "có gửi lệnh", thì một chiến lược swing đúng không có tín hiệu trong ba ngày sẽ bị tính là chết — và bạn sẽ tối ưu sai thứ.
Bài này nói về việc đo cho đúng. Phần đầu là bốn chỉ số thật sự cần đo (MTBF, MTTR, Availability, chi phí downtime) và công thức của từng chỉ số. Phần giữa là bốn cách đo phổ biến — ba cách cho con số sai và vì sao. Phần sau là bảng theo dõi sự cố để bạn điền, mục tiêu uptime theo từng loại bot (gợi ý: "càng cao càng tốt" là sai), và bốn việc cải thiện uptime có lợi nhất về mặt chi phí.
1. Vì sao "uptime 99,9%" của bạn có thể là con số sai
Hãy bắt đầu bằng một thí nghiệm tư duy. Bạn chạy bot từ ngày 1 đến ngày 30. Trong tháng đó, ba sự cố xảy ra, mỗi lần bot chết khoảng hai giờ. Cùng một tháng đó, uptime của bạn là bao nhiêu?
Nếu bạn đo thời gian VPS bật: VPS có thể chưa từng tắt. Kết quả: 100%.
Nếu bạn đo thời gian có tiến trình `terminal64.exe`: nếu MT5 treo mà không bị kill, tiến trình vẫn tồn tại. Kết quả: gần 100%.
Nếu bạn đo thời gian EA thật sự ghi nhịp heartbeat: 6 giờ chết trong 720 giờ, tức 99,17%.
Ba con số cho cùng một thực tế: 100%, ~100%, và 99,17%. Trong khi sự thật là bot của bạn mất sáu giờ làm việc. Nếu sáu giờ đó rơi vào những thời điểm quan trọng, thiệt hại có thể bằng cả tháng lợi nhuận.
Đây là lý do uptime phải được đo trên đúng đối tượng bạn quan tâm. Và đối tượng bạn quan tâm không phải máy, không phải tiến trình — mà là hoạt động của EA.
Có một cách kiểm tra nhanh để biết hệ thống đo của bạn có đúng hay không: hỏi xem nó có phát hiện được ô "MT5 treo" hay không. Nếu câu trả lời là không, con số uptime của bạn đang bỏ qua đúng loại sự cố phổ biến nhất và tốn kém nhất.
2. Bốn chỉ số cần đo
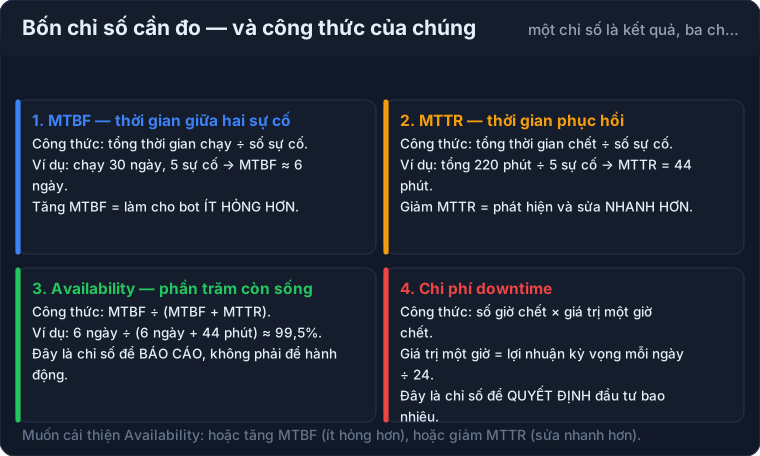
Chỉ số 1 — MTBF (Mean Time Between Failures): thời gian trung bình giữa hai sự cố.
Công thức: tổng thời gian chạy ÷ số sự cố.
Ví dụ: chạy 30 ngày, 5 sự cố → MTBF ≈ 6 ngày. Nghĩa là trung bình cứ 6 ngày lại có một lần bot chết.
MTBF nói về độ ổn định. Muốn tăng MTBF, bạn phải làm cho bot ít hỏng hơn — sửa nguyên nhân gốc: cấu hình Windows Update, thêm RAM, sửa bộ lọc điều kiện, ổn định kết nối.
Chỉ số 2 — MTTR (Mean Time To Recovery): thời gian trung bình để phục hồi.
Công thức: tổng thời gian chết ÷ số sự cố.
Ví dụ: tổng 220 phút chết ÷ 5 sự cố → MTTR = 44 phút. Nghĩa là mỗi khi có sự cố, trung bình 44 phút sau bot mới chạy lại.
MTTR nói về khả năng phát hiện và phục hồi. Đây là chỉ số bạn cải thiện được nhanh nhất, vì phần lớn MTTR không nằm ở việc sửa — mà ở thời gian từ lúc sự cố xảy ra tới lúc bạn biết. Nếu bạn phát hiện vào buổi sáng thay vì trong 30 giây, MTTR của bạn sẽ luôn được đo bằng giờ, bất kể bạn sửa nhanh đến đâu.
Chỉ số 3 — Availability (độ sẵn sàng): phần trăm thời gian bot thật sự làm việc.
Công thức: MTBF ÷ (MTBF + MTTR).
Ví dụ: 6 ngày ÷ (6 ngày + 44 phút) ≈ 99,5%.
Đây là chỉ số bạn báo cáo, không phải chỉ số bạn hành động trực tiếp. Vì nó là kết quả của hai chỉ số kia: muốn tăng Availability, hoặc tăng MTBF, hoặc giảm MTTR. Không có cách thứ ba.
Chỉ số 4 — Chi phí downtime: bao nhiêu tiền một giờ chết.
Công thức: số giờ chết × giá trị một giờ chết, trong đó giá trị một giờ = lợi nhuận kỳ vọng mỗi ngày ÷ 24.
Đây là chỉ số duy nhất trả lời được câu hỏi "tôi nên đầu tư bao nhiêu để cải thiện uptime?" Nếu một giờ chết có giá trị 20 USD, việc trả thêm 10 USD/tháng cho một gói VPS ổn định hơn là quyết định rõ ràng. Nếu một giờ chết có giá trị 2 USD thì có lẽ không.
3. Bốn cách đo, ba cách cho con số sai
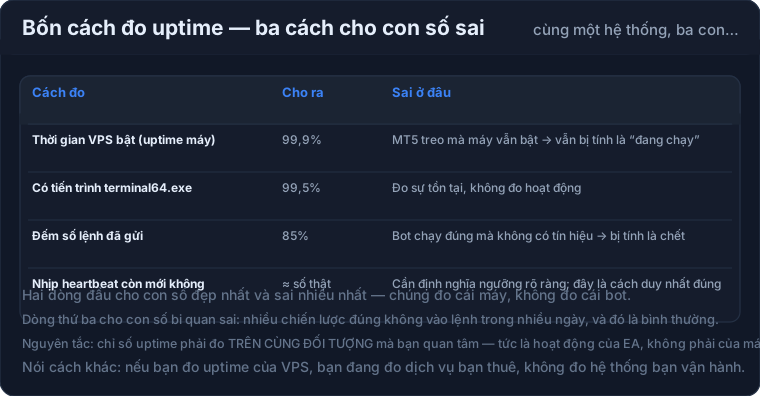
Cách 1 — Thời gian VPS bật. Cho con số đẹp nhất (thường 99,9% trở lên) và sai nhiều nhất. Nó đo dịch vụ bạn thuê, không đo hệ thống bạn vận hành. Trong thực tế, uptime VPS là chỉ số của nhà cung cấp — hữu ích để đánh giá họ, vô nghĩa để đánh giá bot của bạn.
Cách 2 — Có tiến trình `terminal64.exe`. Đo sự tồn tại, không đo hoạt động. Đây là cách sai phổ biến nhất trong các hệ thống giám sát tự làm, và nó có hại kép: không phát hiện sự cố, đồng thời cho bạn cảm giác an toàn sai.
Cách 3 — Đếm số lệnh đã gửi. Nghe có vẻ hợp lý nhưng cho con số bi quan sai. Nhiều chiến lược đúng không vào lệnh trong nhiều ngày: bot swing có thể không giao dịch cả tuần, bot có bộ lọc tin tức có thể đứng ngoài nhiều ngày liền. Nếu bạn đo uptime bằng số lệnh, bạn sẽ thấy uptime 85% và đi tìm một sự cố không tồn tại.
Cách 4 — Nhịp heartbeat còn mới không. Đây là cách duy nhất đúng, với một điều kiện: bạn phải định nghĩa ngưỡng rõ ràng. "Nhịp còn mới" nghĩa là gì? Câu trả lời phải cụ thể: nhịp cuối không quá 90 giây trong phiên giao dịch, và không quá 5 phút ngoài phiên. Có định nghĩa cụ thể, phép đo mới lặp lại được — và chỉ số uptime mới có ý nghĩa để so sánh giữa các tháng.
Điểm chung của ba cách sai: chúng đo một thứ dễ đo hơn thay vì thứ cần đo. Đó là cám dỗ tự nhiên khi xây hệ thống — và cũng là lý do nhiều trader có "hệ thống giám sát" nhưng vẫn mất những đêm trắng.
4. Định nghĩa "bot đang chạy" để đo được
Bạn không thể đo một thứ chưa được định nghĩa. Vì vậy hãy viết định nghĩa ra, và viết cụ thể tới mức có thể kiểm tra bằng máy:
Bot đang chạy khi, tại thời điểm kiểm tra, cả hai điều sau đều đúng: 1. EA đã ghi nhịp heartbeat trong vòng 90 giây gần nhất. 2. Trong phiên giao dịch của symbol, tick cuối không cũ hơn 120 giây.
Ngoài phiên giao dịch, điều kiện 2 được miễn — nhưng điều kiện 1 thì không bao giờ được miễn. Đây là điểm quan trọng: cuối tuần không có tick là bình thường, nhưng EA vẫn phải sống. Nếu bạn miễn cả hai điều kiện ngoài phiên, bạn sẽ không biết EA đã chết từ tối thứ Sáu cho tới sáng thứ Hai.
Hai con số 90 và 120 giây không phải con số thiêng. Điều quan trọng là chúng được viết ra, được dùng nhất quán, và không được chỉnh vào cuối tuần. Nếu bạn chỉnh ngưỡng mỗi khi thấy cảnh báo, chỉ số uptime của bạn sẽ không còn so sánh được giữa các tháng — và bạn mất khả năng biết mình đang tiến bộ hay tệ đi.
Một lưu ý về cách tính: khi đo uptime theo nhịp heartbeat, bạn cần chọn một tần suất lấy mẫu và giữ nó cố định. Ví dụ: kiểm tra mỗi 60 giây, và mỗi lần kiểm tra cho ra một điểm "sống" hoặc "chết". Uptime tháng = số điểm sống ÷ tổng số điểm. Cách này chấp nhận được sai số lớn nhất bằng một chu kỳ lấy mẫu, và đó là mức sai số bạn có thể sống chung.
5. Bảng theo dõi sự cố theo tháng
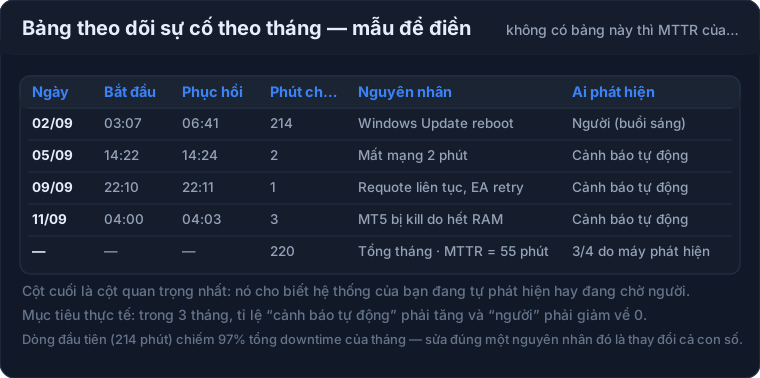
Không có bảng này, MTTR của bạn chỉ là cảm giác. Với bảng này, sau hai tháng bạn sẽ có dữ liệu để biết mình đang cải thiện hay không.
Sáu cột và cách điền:
Ngày, giờ bắt đầu. Giờ bắt đầu là giờ bot ngừng làm việc, không phải giờ bạn phát hiện. Với hệ thống có heartbeat, bạn biết con số này chính xác tới giây. Với hệ thống không có heartbeat, bạn chỉ có thể ước lượng — và đó là một lý do nữa để dựng heartbeat.
Giờ phục hồi. Giờ bot chạy lại và có nhịp mới, không phải giờ bạn đóng RDP.
Số phút chết. Hiệu của hai mốc trên. Cộng dồn cả tháng để ra tổng downtime.
Nguyên nhân. Viết ngắn và cụ thể: "Windows Update reboot", "hết RAM", "mất mạng", "EA rớt chart". Tránh viết "lỗi hệ thống" — vô nghĩa.
Ai phát hiện. Đây là cột quan trọng nhất và cũng là cột hay bị bỏ trống. Giá trị chỉ có hai: "người" hoặc "cảnh báo tự động".
Vì sao cột cuối quan trọng đến vậy? Vì nó đo chất lượng của hệ thống giám sát, chứ không đo chất lượng của bot. Nếu trong danh sách của bạn, phần lớn sự cố do người phát hiện, thì vấn đề lớn nhất của bạn không phải là bot hay hỏng — mà là bạn chưa có hệ thống phát hiện. Và đó là vấn đề dễ sửa nhất trong tất cả.
Cách đọc bảng sau một tháng:
- Nếu một dòng chiếm phần lớn tổng số phút, hãy sửa đúng nguyên nhân đó trước. Trong bảng mẫu, dòng đầu tiên (Windows Update reboot) chiếm 214 trong 220 phút — sửa một nguyên nhân đó thay đổi gần như toàn bộ con số.
- Nếu nhiều dòng nhỏ cùng loại, bạn có vấn đề hệ thống chứ không phải sự cố lẻ. Ví dụ năm lần "mất mạng 2 phút" nghĩa là vấn đề ở đường mạng, không phải ở từng lần.
- Nếu tỉ lệ "cảnh báo tự động" thấp, hãy dựng lớp giám sát trước khi làm bất cứ việc gì khác. Không có phát hiện, mọi cải thiện khác đều bị đo sai.
6. Mục tiêu uptime theo loại bot
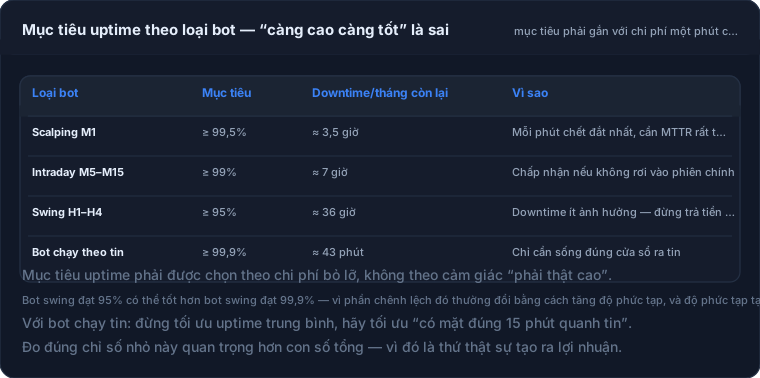
Đây là phần mà nhiều người làm sai vì tin rằng "uptime càng cao càng tốt". Trong thực tế, mục tiêu uptime phải được chọn theo chi phí của việc bỏ lỡ, không theo cảm giác.
Scalping M1: mục tiêu ≥ 99,5% (khoảng 3,5 giờ downtime một tháng). Với bot scalping, mỗi phút chết là một phút mất cơ hội có thể không lặp lại. Đây là loại bot cần MTTR thấp nhất — và là loại bot hưởng lợi nhiều nhất từ việc phát hiện tự động trong 30 giây.
Intraday M5–M15: mục tiêu ≥ 99% (khoảng 7 giờ một tháng). Chấp nhận được nếu downtime không rơi vào phiên chính. Đây là mức mục tiêu vừa phải cho đa số trader bán tự động.
Swing H1–H4: mục tiêu ≥ 95% (khoảng 36 giờ một tháng). Đây là chỗ mà việc hiểu đúng chỉ số tiết kiệm tiền thật. Bot swing vào lệnh vài lần một tuần; nếu downtime xảy ra vào lúc không có tín hiệu, nó không gây thiệt hại gì. Đẩy uptime từ 95% lên 99,9% cho bot swing thường đổi bằng cách tăng độ phức tạp — và độ phức tạp tạo ra sự cố mới, có thể làm giảm uptime thật.
Bot chạy theo tin: mục tiêu ≥ 99,9% (khoảng 43 phút một tháng). Nhưng với loại bot này, đừng tối ưu uptime trung bình — hãy tối ưu "có mặt đúng 15 phút quanh tin". Đây là chỉ số nhỏ nhưng là chỉ số thật sự tạo ra lợi nhuận. Một bot chạy 99,99% thời gian nhưng chết đúng ba lần ra tin quan trọng là một bot vô dụng; một bot có uptime 95% nhưng luôn sống quanh tin lại là bot tốt.
7. Từ uptime tới tiền: bao nhiêu một giờ downtime
Đây là phép tính biến một chỉ số kỹ thuật thành một con số bạn có thể dùng để quyết định.
Bước 1 — Tính lợi nhuận kỳ vọng một ngày. Không dùng con số của tháng tốt nhất. Dùng kỳ vọng dài hạn trên cơ sở backtest hoặc kết quả nhiều tháng: ví dụ 30 USD/ngày.
Bước 2 — Tính giá trị một giờ. 30 USD ÷ 24 giờ ≈ 1,25 USD/giờ. Nhưng lưu ý: bot không kiếm tiền đều theo giờ. Nếu phần lớn cơ hội nằm trong 4 giờ của phiên Âu–Mỹ, thì một giờ trong phiên đó có giá trị bằng 30 USD ÷ 4 ≈ 7,5 USD/giờ, không phải 1,25 USD.
Đây là điểm quan trọng và bị bỏ qua nhiều nhất: giá trị của một giờ downtime phụ thuộc vào giờ nào trong ngày. Với bot có khoảng 4 giờ quan trọng mỗi ngày, chi phí downtime sẽ chênh nhau gấp sáu lần giữa "chết lúc 3 giờ sáng" và "chết lúc 9 giờ tối".
Bước 3 — Nhân với số giờ chết thật. Từ bảng theo dõi ở mục 5: 220 phút = 3,67 giờ. Nếu phần lớn số đó rơi vào khung quan trọng: 3,67 × 7,5 ≈ 27,5 USD. Nếu rơi vào khung im ắng: 3,67 × 1,25 ≈ 4,6 USD.
Bước 4 — So với chi phí cải thiện. Một gói VPS ổn định hơn tốn thêm 10 USD/tháng; một hệ thống giám sát tốn 0–10 USD/tháng; một lớp ngoài VPS có thể miễn phí. Với 27,5 USD tiết kiệm được mỗi tháng, việc chi 20 USD là hợp lý. Với 4,6 USD, hãy xem lại — có thể vấn đề bạn cần giải quyết không phải uptime mà là điều gì khác.
Phép tính này cũng cho bạn một ngưỡng để trả lời câu hỏi khó: "tôi có nên tự làm hay mua?" Nếu chi phí thời gian để tự làm vượt quá số tiền tiết kiệm được trong 12 tháng, hãy mua. Nếu bạn thích tự làm và học được thứ gì đó có giá trị lâu dài, chi phí đó có thể hợp lý — nhưng hãy gọi nó bằng tên đúng: đó là chi phí học, không phải chi phí tiết kiệm.
8. Bốn việc cải thiện uptime có lợi nhất
Nếu bạn chỉ làm bốn việc, đây là bốn việc theo thứ tự lợi ích trên công sức bỏ ra:
Việc 1 — Phát hiện tự động. Đây là việc có tỉ lệ lợi ích/công sức cao nhất, và nó giảm MTTR ngay lập tức mà không cần sửa bất kỳ nguyên nhân gốc nào. Chuyển từ "phát hiện sau 6 giờ" sang "phát hiện sau 30 giây" giảm MTTR từ hơn 200 phút xuống còn vài phút, trên mọi sự cố trong tương lai. Không có việc nào khác cho lợi ích lớn đến vậy với ít công đến vậy.
Việc 2 — Sửa nguyên nhân chiếm nhiều phút nhất. Đừng sửa mọi thứ. Hãy nhìn bảng theo dõi và sửa đúng dòng chiếm nhiều phút nhất. Trong thực tế, thường chỉ có một hoặc hai nguyên nhân chiếm phần lớn tổng downtime — ví dụ Windows Update tự khởi động lại, hoặc hết RAM. Sửa hai thứ đó có thể tăng uptime nhiều hơn sửa hai mươi thứ nhỏ.
Việc 3 — Tự động phục hồi có giới hạn. Cho hệ thống tự khởi động lại MT5 khi phát hiện treo, với giới hạn số lần (ví dụ 3 lần/giờ) và luôn thông báo. Việc này đặc biệt hiệu quả với các sự cố xảy ra ban đêm, khi không ai có thể can thiệp. Lưu ý điều kiện: chỉ tự phục hồi khi an toàn — không tự khởi động lại khi có lệnh đang mở mà chưa có stop-loss phía server.
Việc 4 — Giảm số lượng nguyên nhân có thể xảy ra. Đơn giản hoá cấu hình: bớt chart không cần thiết, bớt EA không dùng, tắt mọi thứ không cần trên VPS, chuẩn hoá cấu hình giữa các máy. Mỗi thứ bạn bỏ đi là một thứ không thể hỏng. Đây là việc kém hấp dẫn nhất trong bốn việc, nhưng lại là việc duy nhất tác động tới MTBF — tức là làm bot ít hỏng hơn, thay vì chỉ phục hồi nhanh hơn.
9. Báo cáo tuần cho chính bạn
Sau khi có đủ dữ liệu, hãy tạo một báo cáo tuần ngắn — cho chính bạn, không cho ai khác. Mục đích không phải là báo cáo, mà là buộc bạn nhìn vào con số mỗi tuần một lần.
Báo cáo gồm sáu dòng:
- Uptime tuần này: 99,2% (so với tuần trước: 98,1%)
- Số sự cố: 3 (tuần trước: 5)
- MTTR: 14 phút (tuần trước: 52 phút)
- Nguyên nhân chiếm nhiều phút nhất: hết RAM lúc 4 giờ sáng (2 lần)
- Do ai phát hiện: 3/3 cảnh báo tự động (tuần trước: 1/5)
- Việc sẽ làm tuần tới: tăng RAM hoặc giảm số nến mỗi chart
Dòng thứ sáu là dòng quan trọng nhất, và là lý do báo cáo tồn tại. Một báo cáo không dẫn tới hành động nào là một báo cáo bạn sẽ bỏ sau ba tuần.
Điều đáng chú ý: sau vài tuần, bạn sẽ nhận ra MTTR giảm nhanh hơn MTBF. Điều này bình thường và nên được mong đợi. Cải thiện phát hiện cho kết quả ngay trong tuần đầu; cải thiện độ ổn định mất nhiều tháng vì nó đòi hỏi sửa nguyên nhân gốc. Nhưng chính vì MTTR giảm nhanh, nó là thứ nên làm trước.
Cách phân biệt "sự cố" với "trạng thái bình thường" khi ghi bảng
Có một loại sai số trong bảng theo dõi mà bạn sẽ gặp ngay trong tháng đầu: ghi nhầm trạng thái bình thường thành sự cố. Điều này làm số liệu của bạn trông tệ hơn thực tế, và tệ hơn nữa là nó khiến bạn đi sửa những thứ không hỏng.
Ba trường hợp hay bị ghi nhầm:
Trường hợp 1 — Cuối tuần không có tick. Rất nhiều người dậy sáng thứ Bảy, thấy nến cuối cùng là 23:59 thứ Sáu, và ghi vào bảng một sự cố 8 tiếng. Nhưng đó là thị trường đóng. Cách phân biệt: nếu heartbeat vẫn phát đều suốt thời gian đó thì EA chưa hề chết — chỉ là không có tick, và không có tick là chuyện bình thường khi thị trường đóng.
Trường hợp 2 — Sau khi khởi động lại, MT5 đang đồng bộ lịch sử. Trong vài phút đầu, chart có thể chưa có dữ liệu và EA chưa phát nhịp. Nếu bạn tính khoảng thời gian này là downtime, mỗi lần reboot bạn sẽ ghi thêm vài phút chết không có thật. Cách phân biệt: trong Journal sẽ có dòng về việc đồng bộ lịch sử. Hãy bắt đầu tính từ khi dòng đó kết thúc.
Trường hợp 3 — Bot đúng chiến lược nhưng không vào lệnh nhiều ngày. Đây không phải sự cố và cũng không phải downtime. Nó chỉ có nghĩa là điều kiện thị trường chưa phù hợp. Cách phân biệt: đọc log NO-SIGNAL và xem lý do bị chặn. Nếu lý do là điều kiện thị trường (spread, giờ, biến động) thì không ghi vào bảng; nếu lý do là lỗi kỹ thuật (không tìm thấy symbol, lỗi kết nối) thì phải ghi.
Nguyên tắc chung để phân biệt: downtime là thời gian bot KHÔNG THỂ làm việc, không phải thời gian bot không làm gì. Hai điều này khác nhau, và nhầm chúng sẽ làm hỏng cả bảng số liệu của bạn chỉ sau vài lần ghi.
Một mẫu ghi ngắn để không bỏ sót
Nếu bạn thấy việc điền sáu cột là quá nhiều cho mỗi sự cố, hãy bắt đầu bằng ba cột và mở rộng sau: thời điểm phát hiện, số phút chết, ai phát hiện. Ba cột này đã đủ để tính MTTR và để trả lời câu hỏi quan trọng nhất — hệ thống của bạn đang tự phát hiện hay đang chờ người.
Sau hai tuần, hãy thêm cột nguyên nhân. Sau một tháng, thêm cột giờ bắt đầu chính xác. Việc mở rộng dần giúp bạn duy trì thói quen ghi — và một bảng ba cột được điền đều đặn có giá trị hơn nhiều so với một bảng sáu cột bị bỏ dở sau bốn ngày.
10. Sai lầm khi tối ưu uptime
Ba sai lầm cuối cùng, đáng nói riêng vì chúng rất phổ biến:
Sai lầm 1 — Tối ưu con số thay vì tối ưu kết quả. Uptime là chỉ số trung gian. Chỉ số cuối cùng là kết quả giao dịch. Nếu bạn tăng uptime từ 98% lên 99,9% nhưng đồng thời thêm ba lớp giám sát chiếm 15% CPU và làm chậm EA, bạn có thể có kết quả tệ hơn. Con số không phải mục tiêu.
Sai lầm 2 — Đặt mục tiêu cao hơn nhu cầu. Như đã nói ở mục 6, mục tiêu uptime phải theo chi phí bỏ lỡ. Đặt mục tiêu 99,99% cho bot swing là trả tiền cho độ phức tạp mà bạn không dùng tới — và độ phức tạp là nguồn sự cố mới.
Sai lầm 3 — Không ghi lại gì cả. Đây là sai lầm phổ biến nhất và cũng dễ sửa nhất. Nếu bạn không ghi lại sự cố, bạn luôn cảm thấy hệ thống của mình "có vẻ ổn" — vì ký ức về những đêm mất trắng phai nhanh hơn dữ liệu. Chỉ cần một file văn bản, sáu cột, và một phút mỗi lần có sự cố.
11. Checklist và tóm lại
Checklist 10 điểm cho việc đo uptime:
- Đã viết ra định nghĩa "bot đang chạy" thành điều kiện kiểm tra được
- Không dùng uptime VPS làm chỉ số cho bot
- Không dùng "có tiến trình" làm chỉ số cho bot
- Không dùng "có gửi lệnh" làm chỉ số cho bot
- Dùng nhịp heartbeat làm chỉ số uptime chính, có ngưỡng cụ thể
- Ngoài phiên: miễn kiểm tra tick, không miễn kiểm tra heartbeat
- Có tần suất lấy mẫu cố định để con số so sánh được giữa các tháng
- Có bảng theo dõi sự cố, luôn điền cột "ai phát hiện"
- Đã tính giá trị một giờ downtime theo khung giờ có cơ hội, không chia đều 24 giờ
- Đang làm việc có lợi nhất trước: phát hiện tự động
Bốn ý cần nhớ:
- Uptime đo cái máy thì vô nghĩa; phải đo hoạt động của EA. Ba cách đo phổ biến nhất đều cho con số đẹp và sai — vì chúng đo một thứ dễ đo hơn thứ cần đo.
- MTTR là chỉ số dễ cải thiện nhất, và phần lớn MTTR nằm ở thời gian phát hiện. Chuyển từ 6 giờ sang 30 giây là thay đổi lớn nhất mà bạn có thể tạo ra trong một buổi chiều.
- Mục tiêu uptime phải theo chi phí bỏ lỡ, không theo cảm giác. Bot swing không cần 99,9%.
- Một giờ downtime có giá trị khác nhau tuỳ khung giờ. Đây là lý do đừng bao giờ chia lợi nhuận ngày cho 24 giờ rồi kết luận.
Nếu bạn muốn đi tiếp: MT5 treo nhưng vẫn "đang chạy" giải thích cách phân loại trạng thái dùng cho việc đo uptime, Quản lý nhiều VPS và nhiều bot là phần mở rộng cho nhiều tài khoản, và Bot chết lúc 3h sáng là bảng tra nguyên nhân để bạn quyết định sửa gì trước.
Bạn không thể cải thiện thứ bạn không đo. Và bạn không thể đo thứ bạn chưa định nghĩa.