Mất kết nối tới sàn giữa phiên: sáu loại ngắt, cách phân biệt với terminal treo và bốn lớp tự phục hồi
Có một câu hỏi mà mọi người chạy bot đều gặp, và hầu hết trả lời sai: "Bot tôi không giao dịch — là do mất kết nối hay do terminal treo?"
Hai sự cố này trông giống hệt nhau trên màn hình. Giá đứng im. Không có lệnh mới. Log im lặng. Nhưng cách xử lý thì ngược nhau: một cái cần chờ và kết nối lại, một cái cần khởi động lại terminal. Chọn sai thì bạn hoặc là không sửa được gì, hoặc là làm tình hình tệ hơn.
Và có một tình huống tệ hơn cả hai: mất kết nối kéo dài trong khi bot đang có lệnh mở. Lúc đó, mỗi phút trôi qua là một phút lệnh của bạn không được quản lý.
Bài này phân biệt sáu loại ngắt kết nối, đưa ra cách phân biệt chúng với terminal treo bằng hai phép đo đơn giản, và trình bày bốn lớp tự phục hồi theo mức rủi ro tăng dần.
1. Vì sao "mất kết nối" là một cái tên gây hiểu nhầm
Trong MT5, có một dòng trạng thái ở góc dưới bên phải hiển thị tình trạng kết nối và giờ của tick cuối cùng. Rất nhiều người chỉ nhìn dòng đó — và kết luận sai.
Vấn đề: "kết nối" trong MT5 là một khái niệm mơ hồ. Nó có thể có nghĩa là:
- Terminal còn giữ được một kênh tới máy chủ sàn.
- Terminal đã đăng nhập thành công vào tài khoản.
- Dữ liệu giá đang thật sự về.
- Terminal còn có thể gửi lệnh thành công.
Bốn điều này không tương đương. Bạn có thể có ba điều đầu đúng và điều thứ tư sai — nghĩa là terminal báo kết nối tốt, giá vẫn về, và không có lệnh nào gửi được.
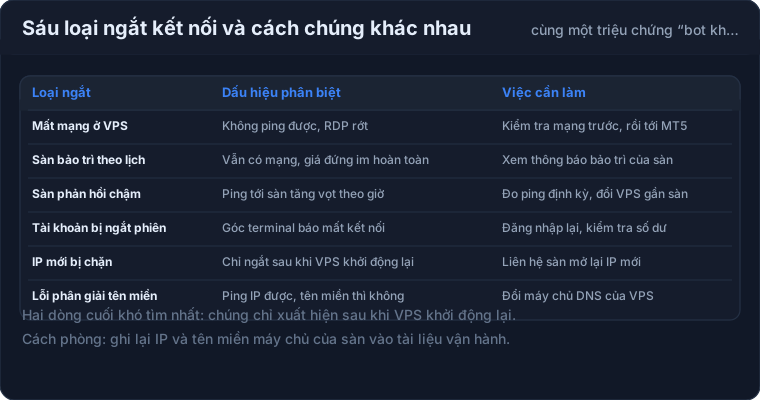
Vì vậy bài này không dùng từ "mất kết nối" như một khái niệm đơn nhất. Nó chia thành sáu loại cụ thể, mỗi loại có dấu hiệu riêng và cách xử lý riêng.
2. Sáu loại ngắt kết nối
2.1. Mất mạng ở VPS
Đây là loại dễ nhận ra nhất và cũng dễ xử lý nhất.
Dấu hiệu: bạn không ping được tới VPS, phiên RDP rớt, và mọi thứ khác ngừng lại cùng lúc. Đây là vấn đề ở tầng hạ tầng — không liên quan tới MT5 hay sàn.
Điều đáng chú ý: khi mạng VPS mất, bạn mất cả khả năng chẩn đoán. Bạn không vào được máy để xem log. Vì vậy việc phát hiện phải được làm từ bên ngoài — bằng một hệ thống giám sát hoặc một máy khác ping tới.
Cách xử lý: kiểm tra mạng trước, rồi tới MT5. Nếu bạn có hệ thống giám sát từ ngoài, nó sẽ cho bạn biết chính xác khoảng thời gian mất mạng — thông tin bạn cần để đối chiếu với lịch sử lệnh sau đó.
2.2. Sàn bảo trì theo lịch
Dấu hiệu đặc trưng: VPS vẫn có mạng bình thường, nhưng giá đứng im hoàn toàn. Bạn ping được tới VPS, RDP hoạt động, nhưng không có tick mới nào.
Đây là loại ngắt hay xảy ra nhất vào cuối tuần, và cũng là loại gây ra nhiều báo động giả nhất — vì một số hệ thống giám sát không biết rằng thị trường đóng vào cuối tuần.
Cách xử lý:
- Biết lịch bảo trì của sàn mình dùng, và ghi vào tài liệu vận hành.
- Cấu hình hệ thống giám sát không cảnh báo trong khung thị trường đóng. Đây là việc quan trọng: nếu bạn nhận cảnh báo mỗi cuối tuần, bạn sẽ bắt đầu bỏ qua cảnh báo — và đó là lúc hệ thống cảnh báo mất giá trị.
- Nếu sàn bảo trì ngoài lịch, hãy ghi lại. Sàn bảo trì đột ngột nhiều lần là tín hiệu để xem lại lựa chọn sàn.
2.3. Sàn phản hồi chậm
Đây là loại tinh vi nhất, vì mọi thứ trông bình thường. Giá vẫn về, chỉ chậm hơn. Lệnh vẫn gửi được, chỉ lâu hơn.
Dấu hiệu: ping tới máy chủ sàn tăng vọt theo giờ — ví dụ từ 20ms lên 400ms. Bạn chỉ phát hiện được nếu bạn đang đo.
Hậu quả thật của loại này không phải "bot ngừng hoạt động" mà là trượt giá tăng. Bot vẫn giao dịch, nhưng mỗi lệnh khớp ở giá tệ hơn. Nếu bạn chỉ theo dõi "bot có chạy không", bạn sẽ không thấy gì cả.
Cách xử lý:
- Đo ping tới máy chủ sàn theo giờ và ghi lại.
- Nếu ping tăng vào một khung giờ cụ thể hằng ngày, đó có thể là vấn đề mạng của nhà cung cấp VPS vào giờ cao điểm.
- Nếu ping tăng dần theo tháng, đó có thể là dấu hiệu VPS bị quá tải.
2.4. Tài khoản bị ngắt phiên đăng nhập
Dấu hiệu: góc terminal báo mất kết nối, nhưng VPS vẫn có mạng và ping tới sàn vẫn bình thường. Sự khác biệt này là điểm phân biệt quan trọng.
Nguyên nhân thường gặp: sàn đặt lại phiên đăng nhập định kỳ, ai đó (hoặc chính bạn) đăng nhập tài khoản đó từ máy khác, hoặc phiên bị hết hạn sau một khoảng thời gian.
Cách xử lý: đăng nhập lại. Nhưng có một điều cần kiểm tra ngay sau đó: trạng thái lệnh đang mở. Trong khoảng thời gian bị ngắt phiên, EA của bạn không quản lý được các lệnh đang mở — nghĩa là stop-loss động, dời stop, và các lệnh chốt lời theo điều kiện đều không hoạt động.
2.5. IP mới bị chặn
Đây là loại khó tìm nhất và cũng gây nhiều bối rối nhất, vì nó chỉ xuất hiện sau khi VPS khởi động lại.
Chuyện xảy ra: nhà cung cấp VPS cấp cho bạn một địa chỉ IP mới (điều này thường xảy ra với máy dùng IP động, hoặc sau khi máy được dựng lại). Một số sàn có danh sách IP được phép truy cập, và IP mới không nằm trong danh sách đó.
Dấu hiệu: mọi thứ bình thường, mạng tốt, ping tốt, nhưng terminal không đăng nhập được. Và điều làm nó khó chẩn đoán: nó xảy ra ngay sau khi VPS khởi động lại — nên bạn dễ quy cho việc khởi động lại chứ không nghĩ tới IP.
Cách xử lý:
- Ghi lại IP hiện tại của VPS vào tài liệu vận hành. Sau mỗi lần khởi động lại, kiểm tra xem IP có đổi không.
- Nếu IP đổi và sàn chặn, liên hệ sàn để mở lại.
- Nếu nhà cung cấp cho phép, dùng IP tĩnh để tránh vấn đề này hoàn toàn. Đây là khoản chi nhỏ đổi lấy một loại sự cố biến mất.
2.6. Lỗi phân giải tên miền
Loại này gây bối rối nhất vì dấu hiệu của nó rất nghịch lý: bạn ping được tới địa chỉ IP của sàn, nhưng không ping được tới tên miền.
Nguyên nhân: máy chủ phân giải tên miền (DNS) mà VPS đang dùng gặp vấn đề. Trình duyệt và nhiều chương trình khác vẫn hoạt động vì chúng được lưu đệm, nhưng kết nối mới thì thất bại.
Cách xử lý: đổi máy chủ DNS của VPS sang một máy chủ công cộng đáng tin cậy hơn. Đây là thay đổi một lần và loại bỏ hoàn toàn loại sự cố này.
Chi tiết thực tế: đây là loại ngắt hay xảy ra với VPS chạy lâu mà không ai nghĩ tới, và nó có thể gây ra những khoảng ngắt chập chờn theo giờ mà bạn không giải thích được. Nếu log của bạn có những khoảng im lặng ngắn không rõ nguyên nhân, hãy kiểm tra DNS.
3. Phân biệt mất kết nối với terminal treo
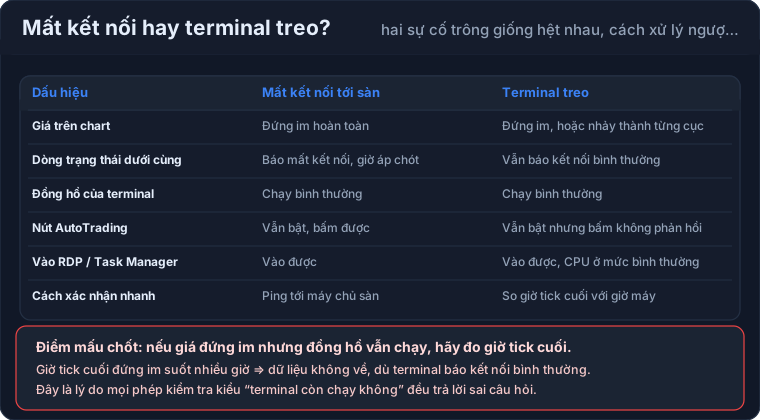
Đây là mục quan trọng nhất của bài, vì chọn sai hướng xử lý sẽ làm mất thời gian hoặc làm tình hình tệ hơn.
Điểm mấu chốt: đo giờ của tick cuối cùng
Có một phép đo duy nhất phân biệt được hai sự cố này trong gần như mọi trường hợp: so giờ của tick cuối cùng mà terminal nhận được với giờ hiện tại của máy.
Trong MQL5, có hai hàm cho việc này:
TimeCurrent()— giờ của tick cuối cùng nhận được từ máy chủ sàn.TimeLocal()— giờ của máy tính (VPS).
Trong một hệ thống khỏe mạnh, hai giá trị này lệch nhau rất ít — vài giây. Khi chúng lệch nhau nhiều giờ, bạn có một vấn đề về dữ liệu.
Cách đọc kết quả:
- Hai giá trị xấp xỉ nhau (lệch vài giây): dữ liệu đang về bình thường. Vấn đề của bạn nằm ở chỗ khác — có thể là tín hiệu, cấu hình, hoặc giới hạn.
- `TimeCurrent()` đứng im, `TimeLocal()` chạy: không có dữ liệu về. Đây là mất kết nối hoặc sàn bảo trì.
Điểm tinh tế, và cũng là điểm quan trọng nhất: `TimeCurrent()` đứng im trong cả hai trường hợp mất kết nối và terminal treo. Vì vậy phép đo này cho bạn biết "có vấn đề về dữ liệu" nhưng không tự phân biệt hai loại.
Hai phép đo phụ để phân biệt
Để phân biệt, cần hai phép đo nữa:
Phép đo 1 — Trạng thái kết nối ở dòng dưới cùng của terminal. Nếu terminal báo mất kết nối, đây là vấn đề kết nối. Nếu terminal vẫn báo kết nối bình thường mà dữ liệu đứng im, đây có thể là terminal treo.
Cẩn thận: dòng trạng thái này không hoàn toàn đáng tin. Terminal có thể báo "kết nối" trong khi dữ liệu không về — đó là trường hợp khó nhất.
Phép đo 2 — Phản hồi của giao diện. Mở menu, đổi khung thời gian, click vào một chart. Nếu giao diện phản hồi bình thường, terminal còn sống. Nếu mọi thao tác đều chậm hoặc không phản hồi, terminal đang treo.
Kết hợp hai phép đo:
| Kết hợp | Kết luận |
|---|---|
| Tick cuối đứng im + dòng trạng thái báo mất kết nối + giao diện phản hồi tốt | Mất kết nối |
| Tick cuối đứng im + dòng trạng thái báo bình thường + giao diện không phản hồi | Terminal treo |
| Tick cuối đứng im + dòng trạng thái báo bình thường + giao diện phản hồi tốt | Dữ liệu không về nhưng kết nối còn — đây là loại khó nhất, thường do sàn bảo trì hoặc lỗi DNS |
| Tick cuối vẫn nhảy + không có lệnh nào | Không phải vấn đề kết nối — quay lại bài về tín hiệu không vào lệnh |
Dòng cuối cùng của bảng này quan trọng: nếu tick vẫn về mà bot không vào lệnh, bạn đang tìm sai chỗ. Hãy kiểm tra cấu hình, bộ lọc, và giới hạn số lệnh — không phải kết nối.
Vì sao sự phân biệt này quan trọng
Hai sự cố cần hai hành động khác nhau:
- Mất kết nối: chờ. Phần lớn các lần ngắt kéo dài dưới 60 giây và tự khỏi. Khởi động lại terminal ngay lập tức là phản ứng thái quá — và có thể làm mất trạng thái.
- Terminal treo: không tự khỏi. Phải khởi động lại. Chờ đợi vô ích.
Nếu bạn xử lý nhầm, kết quả là: bạn chờ trong khi terminal đã treo (mất nhiều giờ), hoặc bạn khởi động lại trong khi chỉ cần chờ 30 giây (mất trạng thái và có thể gây gửi trùng lệnh).
4. Bốn lớp tự phục hồi
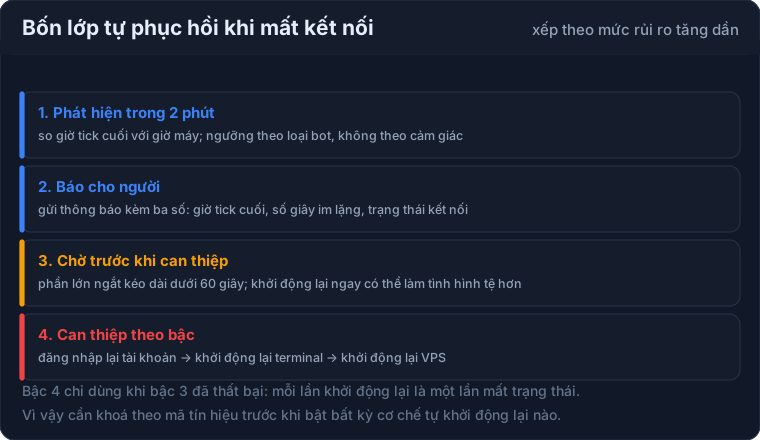
Bốn lớp dưới đây xếp theo mức rủi ro tăng dần. Nguyên tắc: chỉ dùng lớp sau khi lớp trước đã thất bại.
Lớp 1 — Phát hiện trong hai phút
Đây là lớp quan trọng nhất, và cũng là lớp duy nhất mà nếu thiếu, ba lớp còn lại trở nên vô nghĩa.
Cách phát hiện: một đoạn kiểm tra nhỏ trong EA hoặc trong một EA riêng, so TimeCurrent() với TimeLocal(). Nếu chênh lệch vượt ngưỡng, có vấn đề.
Điểm cần cẩn thận: ngưỡng phải theo loại bot, không theo cảm giác.
- Với bot scalping chạy M1, 60 giây im lặng có thể đã là bất thường — nhưng cần cẩn thận với những khung giờ thanh khoản mỏng, khi một phút có thể không có tick nào.
- Với bot swing, 5 phút im lặng là bình thường trong phiên Á.
- Với mọi bot, cuối tuần im lặng là bình thường và phải được loại trừ khỏi kiểm tra.
Đây là lý do ngưỡng cuối tuần quan trọng: nếu hệ thống của bạn gửi cảnh báo mỗi cuối tuần, bạn sẽ bắt đầu bỏ qua cảnh báo — và đó là lúc nó mất giá trị.
Lớp 2 — Báo cho người
Khi lớp 1 phát hiện vấn đề, lớp 2 đưa thông tin tới bạn.
Một thông báo tốt cần có bốn thứ:
- Loại vấn đề — mất dữ liệu, mất kết nối, hay không rõ.
- Giờ của tick cuối cùng — để bạn biết nó đã đứng im bao lâu.
- Số giây im lặng — con số trực tiếp để bạn quyết định mức khẩn cấp.
- Trạng thái lệnh đang mở — số lệnh, tổng khối lượng, và lãi/lỗ hiện tại.
Thứ tư là thứ hay bị bỏ nhất và cũng quan trọng nhất khi bạn đang ở ngoài. Nếu bot của bạn có lệnh đang mở khi mất kết nối, mức khẩn cấp cao hơn nhiều so với khi không có lệnh nào.
Về kênh thông báo: hãy dùng một kênh mà bạn thật sự đọc. Với hầu hết người chạy bot, một ứng dụng nhắn tin cá nhân là đủ và miễn phí. Cảnh báo qua email thường bị bỏ qua.
Lớp 3 — Chờ trước khi can thiệp
Đây là lớp bị bỏ qua nhiều nhất, và cũng là lớp tiết kiệm nhiều rắc rối nhất.
Sự thật: phần lớn các lần ngắt kết nối kéo dài dưới 60 giây. Mạng chập chờn một nhịp, một gói tin bị mất, và mọi thứ trở lại bình thường. Nếu bạn khởi động lại terminal ngay lập tức, bạn biến một sự cố 30 giây thành một sự cố 5 phút — và bạn mất trạng thái.
Vì vậy lớp 3 là: đặt một khoảng chờ trước khi hành động. Ví dụ: nếu im lặng trên 90 giây, bắt đầu đăng nhập lại tài khoản. Nếu im lặng trên 5 phút, khởi động lại terminal.
Hai chi tiết quan trọng:
- Khoảng chờ phải dài hơn thời gian ngắt thông thường. Nếu bạn chưa biết thời gian ngắt thông thường của mình là bao lâu, hãy đo trong hai tuần trước khi đặt ngưỡng.
- Khoảng chờ phải tính từ lúc phát hiện, không từ lúc bắt đầu im lặng. Nếu không, bạn có thể hành động ngay khi vừa phát hiện.
Lớp 4 — Can thiệp theo bậc
Chỉ dùng khi lớp 3 đã thất bại. Bốn bậc, từ ít rủi ro nhất:
Bậc 1 — Đăng nhập lại tài khoản. Rủi ro thấp nhất. Giải quyết được loại ngắt do phiên hết hạn. Không mất trạng thái.
Bậc 2 — Khởi động lại terminal. Rủi ro trung bình. Mất trạng thái trong bộ nhớ. Nếu EA của bạn lưu trạng thái trong RAM, nó sẽ quên mình đã làm gì.
Bậc 3 — Khởi động lại VPS. Rủi ro cao. Mất trạng thái, mất kết nối trong vài phút, và có thể đổi IP (xem mục 2.5).
Bậc 4 — Đóng và mở lại lệnh bằng tay. Rủi ro cao nhất, và là hành động con người. Chỉ dùng khi bạn đã đánh giá được tình trạng lệnh đang mở.
Một lưu ý quan trọng về bậc 2 và 3: mỗi lần khởi động lại là một lần bot có thể gửi lại lệnh cũ. Nếu logic gửi lệnh của bạn không có khoá theo mã tín hiệu hoặc kiểm tra vị thế đã có, việc tự động khởi động lại có thể gây ra lệnh trùng — và bạn đã biến một sự cố nhỏ thành một sự cố lớn hơn.
Vì vậy: trước khi bật bất kỳ cơ chế tự khởi động lại nào, hãy đảm bảo bot có lớp chống trùng lệnh. Hai thứ này đi cùng nhau, không tách rời.
5. Mất kết nối khi đang có lệnh mở
Đây là tình huống tệ nhất của cả bài, và nó cần một thứ tự hành động khác hẳn.
Vấn đề cốt lõi: trong khoảng thời gian mất kết nối, các lệnh đang mở không được quản lý. Cụ thể là:
- Stop-loss động không được dời.
- Lệnh chốt lời theo điều kiện không được kích hoạt.
- Các lệnh đóng một phần không được thực hiện.
- Nếu chiến lược có logic đóng lệnh theo thời gian, nó không chạy.
Nghĩa là: rủi ro của bạn cao hơn bình thường trong suốt thời gian đó, và nó cao lên theo thời gian.
Thứ tự hành động đúng
Bước 1 — Kiểm tra rủi ro trước, khôi phục kỹ thuật sau. Mở ứng dụng điện thoại của sàn (không cần VPS). Bạn cần biết: có bao nhiêu lệnh, tổng khối lượng, lãi/lỗ, và lệnh nào không có stop-loss.
Đây là bước bị bỏ qua nhiều nhất, vì bản năng là muốn sửa lỗi kỹ thuật trước. Nhưng nếu tài khoản đang có rủi ro không được quản lý, mỗi phút bạn dành để sửa kỹ thuật là một phút rủi ro tiếp tục.
Bước 2 — Với lệnh thiếu bảo vệ, đặt bảo vệ trước. Nếu có lệnh đang mở mà không có stop-loss trên sàn, hãy đặt stop-loss bằng tay qua ứng dụng điện thoại. Đây là hành động duy nhất trong cả quy trình có thể trực tiếp cứu bạn khỏi mất tiền.
Lưu ý: nhiều EA đặt stop-loss "mềm" trong code (tự kiểm tra và đóng lệnh) thay vì đặt trên sàn. Với những EA đó, khi mất kết nối, lệnh của bạn không có bảo vệ nào. Đây là điểm yếu thiết kế cần biết trước, không phải phát hiện trong lúc sự cố.
Bước 3 — Khôi phục kết nối theo bậc. Lúc này rủi ro đã được xử lý, và bạn có thể làm kỹ thuật mà không phải lo về tiền.
Bước 4 — Xác nhận trạng thái sau khi khôi phục. Kiểm tra: số lệnh trên sàn có khớp với số lệnh bot nghĩ không? Bot có coi những lệnh đang mở là "của mình" không, hay là "lệnh lạ"?
Đây là điểm nguy hiểm nhất của bước 4: nếu bot đọc trạng thái từ file nhưng file bị mất, nó có thể coi lệnh cũ là lạ và mở thêm lệnh mới. Đó là tình huống trùng lệnh.
Cách xử lý an toàn: khởi động bot ở chế độ chỉ đọc trước. Cho nó chạy, đọc log, xem nó nghĩ gì về những lệnh đang có — nhưng tắt AutoTrading. Chỉ bật khi bạn chắc rằng bot hiểu đúng trạng thái tài khoản.
6. Cách đo để biết mình đang có bao nhiêu lần ngắt
Bạn không thể cải thiện thứ bạn không đo. Với mất kết nối, việc đo rất đơn giản:
Việc 1 — Ghi lại mỗi lần im lặng vượt ngưỡng. Một dòng: thời điểm bắt đầu, thời điểm kết thúc, thời lượng, và phân loại sơ bộ (mất mạng, sàn bảo trì, không rõ).
Việc 2 — Đếm theo tháng. Hai con số cần biết: số lần ngắt, và tổng thời gian ngắt. Hai con số này thường khác nhau theo hướng đáng chú ý — có tháng chỉ 2 lần ngắt nhưng tổng 4 giờ.
Việc 3 — Đo độ trễ trung bình tới sàn, theo tuần. Đây là chỉ số báo trước. Nếu độ trễ tăng dần, số lần ngắt sắp tăng.
Việc 4 — So với lịch sử lệnh. Đối chiếu những khoảng im lặng với những khoảng không có lệnh trong lịch sử. Đây là cách bạn biết mất kết nối đã gây thiệt hại gì — không chỉ biết nó đã xảy ra.
Việc 4 là việc quan trọng nhất và cũng hay bị bỏ nhất. Một tháng có 3 lần ngắt nghe không tệ. Nhưng nếu cả 3 lần đều rơi vào lúc có tín hiệu, bạn đã mất 3 giao dịch.
7. Câu hỏi thường gặp
Hỏi: Làm sao biết việc mất kết nối là do VPS hay do sàn?
Đo ping tới máy chủ sàn từ một máy khác (máy của bạn), và so với thời điểm sự cố. Nếu máy khác cũng không ping được tới sàn, vấn đề ở phía sàn hoặc ở đường truyền chung. Nếu máy khác ping tốt mà VPS không ping được, vấn đề ở VPS hoặc ở mạng của nhà cung cấp VPS.
Hỏi: Có nên bật cơ chế tự khởi động lại terminal không?
Chỉ nên bật sau khi bot có lớp chống trùng lệnh. Không có lớp đó, tự khởi động lại có thể làm lệnh bị gửi hai lần — và bạn biến một sự cố 5 phút thành một sự cố tốn tiền.
Nếu đã có lớp chống trùng, hãy bật với hai điều kiện: khoảng chờ trước khi hành động, và giới hạn số lần khởi động lại mỗi ngày.
Hỏi: Vì sao cuối tuần hay có cảnh báo mất kết nối?
Vì thị trường đóng. Đây là hành vi bình thường, không phải sự cố. Cách sửa: loại trừ khung thị trường đóng khỏi kiểm tra. Nếu bạn không làm việc này, bạn sẽ nhận hai cảnh báo mỗi tuần và bắt đầu bỏ qua tất cả cảnh báo.
Hỏi: Tôi nên dùng ngưỡng bao nhiêu giây để coi là mất kết nối?
Đo trước, đặt sau. Chạy EA ghi lại thời gian im lặng lớn nhất trong mỗi giờ, trong hai tuần. Lấy giá trị lớn nhất trong hai tuần đó nhân với 2. Đó là ngưỡng của bạn — nó dựa trên dữ liệu thật của chính hệ thống bạn.
Hỏi: Khi mất kết nối mà có lệnh mở, có nên đóng lệnh bằng tay không?
Chỉ khi bạn đã đánh giá được rủi ro và không có cách nào khác. Đóng lệnh bằng tay nghĩa là bạn bỏ luôn logic thoát lệnh của chiến lược. Trong nhiều trường hợp, cách đúng là đặt stop-loss bảo vệ rồi để bot tiếp tục quản lý khi kết nối trở lại.
Hỏi: Bao lâu thì mất kết nối nên được coi là sự cố, không phải bình thường?
Một quy tắc thực dụng: nếu tổng thời gian mất kết nối trong tháng vượt 0,5% tổng thời gian (khoảng 3,5 giờ một tháng), đó là mức cần xem lại. Và nếu phần lớn thời gian đó rơi vào giờ giao dịch chính, mức cần xem lại thấp hơn nhiều.
8. Checklist và tóm lại
Kiểm tra ngay (30 phút):
- [ ] Thêm đoạn log so
TimeCurrent()vớiTimeLocal()và in cả hai - [ ] Ghi lại ngưỡng im lặng bình thường vào giờ giao dịch của hệ thống bạn
- [ ] Kiểm tra hệ thống giám sát có loại trừ cuối tuần không
- [ ] Ghi IP hiện tại của VPS vào tài liệu vận hành
- [ ] Kiểm tra máy chủ DNS mà VPS đang dùng
- [ ] Kiểm tra EA có đặt stop-loss trên sàn hay chỉ đặt "mềm" trong code
Trong tháng:
- [ ] Ghi lại mỗi lần im lặng vượt ngưỡng, kèm phân loại sơ bộ
- [ ] Đo ping tới sàn định kỳ và ghi lại
- [ ] Đặt ngưỡng cảnh báo theo loại bot, có loại trừ thị trường đóng
- [ ] Đặt khoảng chờ trước khi can thiệp
- [ ] Kiểm tra bot đã có lớp chống trùng lệnh chưa, trước khi bật tự khởi động lại
Bốn nguyên tắc để nhớ:
- "Mất kết nối" không phải một khái niệm. Có sáu loại, và mỗi loại cần cách xử lý riêng.
- Phép đo quyết định là giờ của tick cuối cùng. So nó với giờ máy — đó là thông tin đầu tiên bạn cần.
- Chờ trước khi can thiệp. Phần lớn ngắt kết nối tự khỏi trong dưới 60 giây, và hành động sớm làm mọi thứ tệ hơn.
- Khi có lệnh mở: tiền trước, máy sau. Kiểm tra rủi ro trên ứng dụng điện thoại trước khi sửa bất cứ thứ gì.
Và nếu bạn chỉ làm được một việc sau khi đọc bài này: hãy thêm một dòng log in ra TimeCurrent() và TimeLocal() cạnh nhau. Đó là một dòng code, và nó là phép đo cơ bản nhất để phân biệt mọi loại sự cố trong bài này.