VPS bị bảo trì đột ngột: ba loại gián đoạn, cách đọc thông báo và năm việc quanh một lần bảo trì
Có một sự cố luôn xảy ra vào lúc bạn không muốn: máy chủ của bạn khởi động lại, hoặc mất điện, hoặc mất mạng — và bạn chỉ biết khi bot đã dừng vài giờ.
Điều làm sự cố này khác với những sự cố khác trong loạt bài này: bạn không kiểm soát được nó. Bạn không thể sửa cấu hình để tránh nó. Bạn chỉ có thể chuẩn bị.
Và tin tốt là chuẩn bị được. Ba loại gián đoạn từ phía nhà cung cấp đòi ba cách chuẩn bị khác nhau, tổng cộng khoảng 20 phút mỗi lần bảo trì, và chúng loại bỏ gần như toàn bộ thiệt hại có thể xảy ra.
Bài này đi qua ba loại gián đoạn, cách đọc một thông báo bảo trì để lấy ra bảy thông tin cần thiết, năm việc cần làm quanh mỗi lần bảo trì, và những câu hỏi bạn nên hỏi nhà cung cấp trước khi sự cố xảy ra.
1. Ba loại gián đoạn — và vì sao nhầm loại là sai cách chống
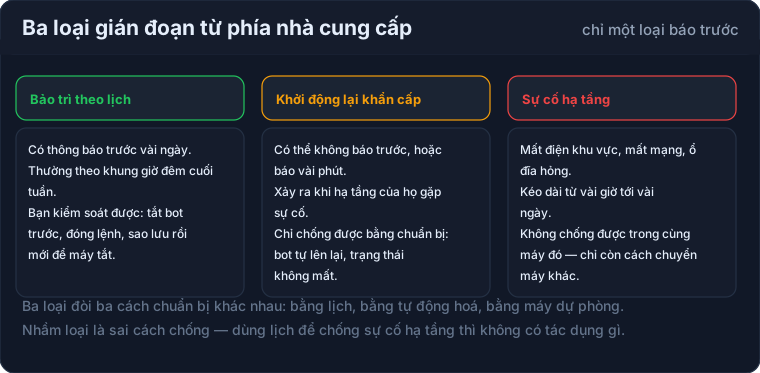
Loại 1 — Bảo trì theo lịch
Đặc điểm: có thông báo trước, thường vài ngày, và thường rơi vào khung giờ đêm cuối tuần.
Đây là loại dễ xử lý nhất, vì bạn kiểm soát được hoàn toàn: bạn biết trước, nên bạn có thể tắt bot chủ động, đóng lệnh, sao lưu, và để máy tắt trong trạng thái sạch.
Cách chuẩn bị đúng cho loại này là quy trình theo lịch: một danh sách việc làm trước và sau giờ bảo trì. Không cần tự động hoá gì phức tạp — chỉ cần một danh sách và 20 phút.
Điều đáng chú ý: loại này vẫn có thể gây thiệt hại, dù bạn đã biết trước. Lý do thường gặp nhất là bạn quên, hoặc bạn nghĩ "chắc nó tự lên lại được". Việc biến nó thành một mục trong lịch có nhắc nhở quan trọng hơn việc có một quy trình hoàn hảo mà không ai nhớ.
Loại 2 — Khởi động lại khẩn cấp
Đặc điểm: có thể không báo trước, hoặc báo trước vài phút. Xảy ra khi hạ tầng của nhà cung cấp gặp sự cố — ổ đĩa có vấn đề, máy chủ vật lý cần thay thành phần, hoặc một sự cố an ninh.
Với loại này, bạn không thể chuẩn bị bằng lịch. Bạn chỉ có thể chuẩn bị bằng tính chất của hệ thống mình:
- Bot tự chạy lại sau khi máy khởi động.
- Trạng thái của bot không mất khi khởi động lại (hoặc nếu mất, bot phải xử lý đúng).
- Bạn biết máy đã lên lại, kể cả khi bạn đang ngủ.
Ba việc đó là ba việc khác nhau, và cái thứ ba thường bị bỏ qua nhất. Máy khởi động lại lúc 3 giờ sáng và bot tự chạy lại lúc 3 giờ 2 phút — nhưng nếu bạn chỉ biết lúc 7 giờ sáng, bạn không có cơ hội phát hiện những gì đã sai trong bốn giờ đó.
Loại 3 — Sự cố hạ tầng
Đặc điểm: kéo dài từ vài giờ tới vài ngày. Mất điện khu vực, mất mạng diện rộng, ổ đĩa hỏng cần phục hồi dữ liệu.
Đây là loại duy nhất mà bạn không thể chống trong cùng một máy. Không có cấu hình nào giúp máy đang mất điện hoạt động trở lại. Cách duy nhất là có một máy khác để chuyển sang.
Vì vậy cách chuẩn bị cho loại 3 là máy dự phòng, không phải quy trình. Hai thứ này không thay thế nhau.
Vì sao nhầm loại là sai cách chống
Điều này quan trọng hơn nó nghe. Ba ví dụ cụ thể:
- Dùng lịch nhắc để chống sự cố hạ tầng: bạn sẽ được nhắc... về một việc không có lịch.
- Dùng tự động hoá để chống bảo trì theo lịch: làm được, nhưng phức tạp hơn cần thiết — vì bạn đã biết trước, chỉ cần có mặt đúng lúc.
- Dùng máy dự phòng để chống khởi động lại 2 phút: không sai, nhưng lãng phí — khởi động lại 2 phút chỉ cần bot tự chạy lại.
Câu hỏi để xác định bạn đang đối mặt loại nào: "tôi có thông báo trước không, và máy có còn nguyên vẹn sau đó không?"
2. Cách đọc một thông báo bảo trì
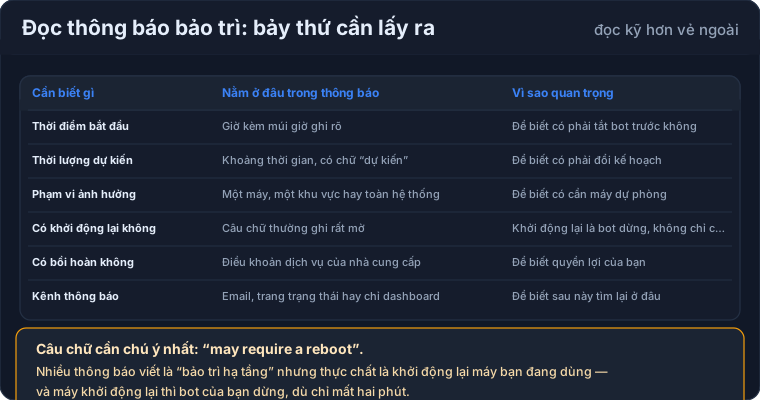
Thông báo bảo trì của nhà cung cấp VPS thường không viết cho người chạy bot. Nó viết cho quản trị viên hệ thống, với giả định rằng bạn hiểu hạ tầng. Nhưng thông tin bạn cần vẫn nằm trong đó — bạn chỉ cần biết lấy cái gì.
Bảy thứ cần lấy ra:
2.1. Thời điểm bắt đầu — kèm múi giờ
Thông báo thường ghi giờ theo múi giờ nào đó. Nếu bạn không để ý, bạn có thể lệch vài giờ.
Cách xử lý: ghi lại giờ bảo trì theo giờ bạn sống, và ghi lại giờ đó theo giờ sàn (vì đó là thời điểm bạn cần so với giờ giao dịch). Hai con số, một dòng.
Điều này nghe nhỏ nhặt nhưng nó là lý do nhiều người lỡ bảo trì. Múi giờ của nhà cung cấp VPS thường là UTC, còn giờ bạn sống là GMT+7. Lệch bảy giờ là đủ để biến "đêm Chủ nhật" thành "sáng thứ Hai".
2.2. Thời lượng dự kiến — và có chữ "dự kiến" không
Thông báo thường ghi "thời lượng dự kiến 2 giờ". Chữ "dự kiến" là thông tin quan trọng: nó có nghĩa là nhà cung cấp không cam kết.
Cách xử lý: với mọi việc bạn lên kế hoạch quanh lần bảo trì, hãy giả định thời lượng gấp đôi. Nếu bảo trì dự kiến 2 giờ, hãy lên kế hoạch cho 4 giờ.
2.3. Phạm vi ảnh hưởng
Ba khả năng, và chúng khác nhau rất nhiều:
- Chỉ máy của bạn — ảnh hưởng nhỏ, có thể không cần làm gì.
- Một khu vực (một trung tâm dữ liệu) — ảnh hưởng tới bạn nếu máy bạn nằm ở đó, và có thể ảnh hưởng tới cả các dịch vụ liên quan.
- Toàn hệ thống — ảnh hưởng rộng, và có thể kèm cả sự cố với hệ thống quản lý tài khoản của nhà cung cấp.
Điều đáng chú ý ở đây: nếu phạm vi là toàn hệ thống, bạn có thể không vào được cả trang quản trị để khởi động lại máy mình. Đây là lý do cần biết trước số điện thoại hoặc kênh hỗ trợ khẩn cấp.
2.4. Có phải khởi động lại không — câu chữ thường ghi rất mờ
Đây là thông tin quan trọng nhất và cũng là thông tin bị viết mờ nhất.
Ba mức độ:
- "Bảo trì hạ tầng" — có thể không ảnh hưởng tới máy bạn chút nào.
- "Máy chủ sẽ được khởi động lại" — bot của bạn dừng, và bạn cần cấu hình tự chạy lại.
- "Máy chủ sẽ được thay thế" — dữ liệu trên máy có thể mất hoàn toàn, và bạn cần bản sao lưu.
Cách xử lý: nếu không rõ, hãy hỏi. Một câu hỏi qua kênh hỗ trợ rẻ hơn nhiều so với việc phát hiện ra máy đã bị thay thế sau khi bảo trì.
Một dấu hiệu thực tế: nếu thông báo có cụm từ tương đương "may require a reboot", hãy coi đó là sẽ khởi động lại. Cụm từ này là cách viết an toàn của nhà cung cấp, và nó thường có nghĩa chắc chắn hơn bạn nghĩ.
2.5. Có bồi hoàn không
Nhiều nhà cung cấp có chính sách bồi hoàn thời gian khi downtime vượt một ngưỡng (ví dụ 99,9% uptime trong hợp đồng). Đây không phải khoản tiền lớn, nhưng nó là quyền lợi của bạn và nó nằm trong điều khoản dịch vụ.
Việc cần làm: một lần, hãy đọc điều khoản dịch vụ của nhà cung cấp và ghi lại ngưỡng bồi hoàn vào tài liệu vận hành. Sau đó, mỗi lần downtime dài, bạn biết có nên gửi yêu cầu hay không.
Điều này có giá trị thứ hai: nó cho bạn một thước đo khách quan. Nếu bạn phải gửi yêu cầu bồi hoàn ba lần trong một năm, bạn đang có vấn đề về lựa chọn nhà cung cấp — và đó là thông tin hữu ích.
2.6. Kênh thông báo — và sau này tìm lại ở đâu
Bạn sẽ cần tìm lại thông báo này khi có sự cố. Câu hỏi: nó nằm ở đâu? Email? Trang trạng thái của nhà cung cấp? Chỉ trong dashboard của tài khoản?
Cách xử lý: lưu lại thông báo vào tài liệu vận hành, kèm ngày nhận. Không phải để tra cứu thường xuyên, mà để khi có sự cố bạn có bằng chứng và mốc thời gian.
2.7. Có kênh trạng thái để theo dõi không
Nhiều nhà cung cấp có một trang trạng thái (status page) công khai, hiển thị tình trạng dịch vụ theo thời gian thực. Nếu có, hãy lưu địa chỉ lại.
Giá trị của nó: khi bot của bạn ngừng giao dịch lúc 3 giờ sáng, câu hỏi đầu tiên là "phía tôi hay phía họ?" Trang trạng thái trả lời câu hỏi đó trong 10 giây.
3. Năm việc làm quanh một lần bảo trì
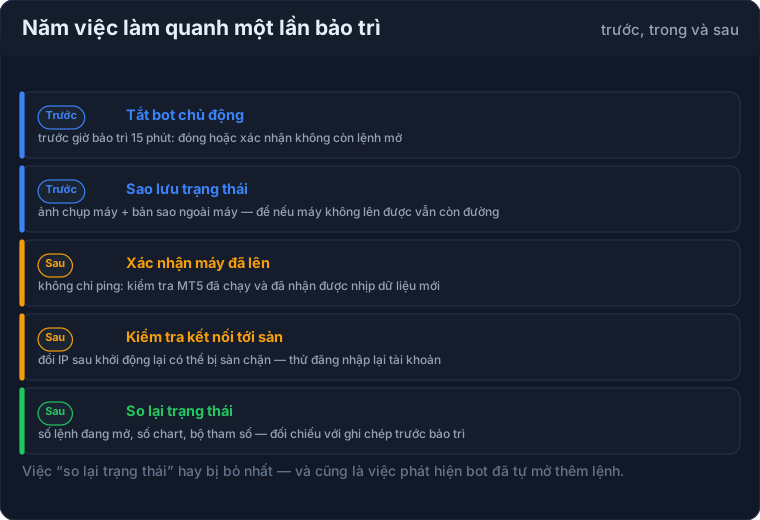
Đây là danh sách thực dụng — tổng cộng khoảng 20 phút, chia thành ba nhóm theo thời điểm.
Trước bảo trì
#### Việc 1 — Tắt bot chủ động, trước giờ bảo trì 15 phút
Lý do của khoảng 15 phút: bạn cần thời gian để xử lý trường hợp có lệnh đang mở. Nếu bạn tắt bot ở giây cuối, bạn có thể không kịp xử lý.
Các bước:
- Quyết định rõ ràng: đóng hết lệnh, hay để lệnh lại? Không để câu hỏi này mở.
- Nếu đóng: đóng theo cách của chiến lược, không phải đóng bằng tay tất cả cùng lúc — trừ khi có lý do cụ thể.
- Nếu để: ghi lại số lệnh, khối lượng, và mức stop-loss của từng lệnh trước khi bot dừng. Đây là dữ liệu bạn cần để kiểm tra sau.
- Tắt AutoTrading.
Quyết định "đóng hay để" phải được viết ra trước, không phải quyết định tại chỗ. Lý do: quyết định tại chỗ thường bị ảnh hưởng bởi lãi/lỗ hiện tại, và đó là cách ra quyết định tệ nhất.
#### Việc 2 — Sao lưu trạng thái
Hai việc, theo thứ tự:
- Ảnh chụp máy (snapshot) nếu nhà cung cấp có. Đây là biện pháp cho trường hợp xấu: máy không lên được sau bảo trì.
- Bản sao ngoài máy — file cấu hình, bộ tham số, kịch bản dựng lại. Đây là biện pháp cho trường hợp tệ nhất: máy bị thay thế.
Điều đáng chú ý: hai việc này không thay thế nhau. Snapshot nằm ở phía nhà cung cấp; nếu tài khoản của bạn gặp vấn đề, snapshot cũng đi theo. Bản sao ngoài máy là thứ bạn kiểm soát hoàn toàn.
Sau bảo trì
#### Việc 3 — Xác nhận máy đã lên, không chỉ ping
Đây là việc mà hầu hết mọi người làm sai: họ ping được tới máy và kết luận "máy đã lên". Nhưng ping chỉ chứng minh card mạng hoạt động.
Ba thứ cần kiểm tra, theo thứ tự:
- Máy có ping được không. Nếu không, dừng ở đây và kiểm tra với nhà cung cấp.
- MT5 đã chạy chưa. Kiểm tra tiến trình. Nhớ rằng tiến trình đang chạy chưa chắc bot đang hoạt động — nhưng nó là điều kiện cần.
- MT5 đã nhận được nhịp dữ liệu mới chưa. Đây là bước quan trọng nhất và hay bị bỏ nhất. Máy đã lên, MT5 đã chạy, nhưng kết nối tới sàn chưa được thiết lập lại. Đây là lúc bạn cần so giờ tick cuối với giờ hiện tại.
#### Việc 4 — Kiểm tra kết nối tới sàn
Sau khi máy khởi động lại, hai thứ có thể thay đổi:
- Địa chỉ IP. Một số nhà cung cấp cấp IP mới sau khi máy khởi động lại, và một số sàn có danh sách IP được phép.
- Phiên đăng nhập. MT5 có thể không tự đăng nhập lại tài khoản.
Cách kiểm tra: đăng nhập lại tài khoản bằng tay một lần, và xác nhận kết nối. Nếu không đăng nhập được và bạn nghi IP, hãy kiểm tra IP hiện tại so với ghi chép trong tài liệu vận hành.
#### Việc 5 — So lại trạng thái
Đây là việc hay bị bỏ nhất, và cũng là việc phát hiện ra nhiều vấn đề nhất.
Bốn thứ cần đối chiếu với ghi chép trước bảo trì:
- Số lệnh đang mở — khớp hay không?
- Số chart và EA đang chạy — có đủ không, có EA nào bị gỡ không?
- Bộ tham số — có phải bộ bạn đang dùng không?
- Trạng thái AutoTrading — có bật lại không?
Câu hỏi quan trọng nhất của việc này: bot có tự mở thêm lệnh nào trong lúc bạn không nhìn không? Đây là kịch bản bạn cần loại trừ — và nó xảy ra khi bot khởi động lại mà không biết mình đã làm gì trước đó.
Nếu bạn tìm thấy lệnh thừa, hãy dừng lại và xử lý trước khi tiếp tục. Đó là dấu hiệu bot của bạn thiếu lớp chống trùng lệnh, và nó sẽ lặp lại ở lần bảo trì sau.
Sau bảo trì vài ngày
Đây là việc thứ sáu, nhưng nó không nằm trong danh sách 20 phút — nó là một dòng trong nhật ký:
Ghi lại kết quả. Ngày bảo trì, thời lượng thực tế so với dự kiến, có vấn đề gì, mất bao lâu để khôi phục. Một dòng.
Giá trị của nó: sau ba lần bảo trì, bạn có dữ liệu để trả lời câu hỏi "nhà cung cấp này có đáng tin không" bằng số, không bằng cảm giác.
4. Chuẩn bị cho loại gián đoạn không báo trước
Ba loại ở mục 1 cần ba cách chuẩn bị. Hai loại đầu có thể chuẩn bị bằng quy trình. Loại thứ ba — sự cố hạ tầng kéo dài — cần một thứ khác.
Máy dự phòng: ba mức
Mức 1 — Không có máy dự phòng. Bạn chấp nhận rằng một sự cố hạ tầng kéo dài nghĩa là bot dừng cho tới khi máy trở lại. Với tài khoản nhỏ và chiến lược không nhạy cảm thời gian, đây là lựa chọn hợp lý — miễn là bạn biết mình đang chọn nó.
Mức 2 — Máy dựng theo giờ. Nhiều nhà cung cấp cho tạo máy theo giờ, và bạn chỉ trả cho thời gian máy chạy. Đây là lựa chọn tốt cho hầu hết người chạy bot cá nhân: chi phí gần bằng không khi không dùng, và bạn có thể dựng máy mới trong vài chục phút.
Điều kiện để mức này hoạt động: bạn phải có kịch bản dựng lại đã được viết và đã thử. Một máy dựng theo giờ không giúp gì nếu bạn cần bốn giờ để cấu hình lại MT5 và EA bằng tay.
Mức 3 — Máy chạy song song. Một VPS thứ hai luôn chạy, sẵn sàng nhận việc. Đây là mức cho tài khoản lớn: chi phí cao hơn, nhưng thời gian chuyển đổi có thể tính bằng phút.
Điều cần cẩn thận ở mức 3: nếu bạn chạy cùng một chiến lược trên hai máy, bạn có rủi ro gửi lệnh trùng. Máy dự phòng phải ở trạng thái chờ (không giao dịch) cho tới khi bạn chủ động bật nó lên.
Thứ tự chuyển sang máy dự phòng
Nếu bạn phải chuyển máy, thứ tự quan trọng:
- Xác nhận máy cũ thật sự không dùng được. Đừng chuyển máy chỉ vì bạn chưa liên hệ được hỗ trợ — hãy chờ một khoảng thời gian hợp lý và có bằng chứng.
- Tắt hoàn toàn việc giao dịch ở máy cũ trước khi bật máy mới. Nếu không, bạn có thể có hai máy cùng giao dịch.
- Xử lý lệnh đang mở trước khi chuyển. Quyết định đóng hay để là quyết định của bạn, không phải quyết định của tình huống.
- Dựng máy mới theo kịch bản đã viết. Đây là lúc kịch bản trả giá trị — nếu bạn phải viết kịch bản trong lúc sự cố, bạn sẽ mất thêm nhiều giờ.
- Kiểm tra đủ năm việc ở mục 3 trước khi cho bot giao dịch tiền thật.
Một lưu ý về bước 2: nếu máy cũ không khởi động được, bạn không thể tắt gì cả. Trong trường hợp đó, bước quan trọng là xác nhận máy cũ chắc chắn không chạy — nếu không, hãy đợi. Hai máy cùng giao dịch trên một tài khoản là tình huống tệ hơn downtime.
5. Năm câu hỏi nên hỏi nhà cung cấp VPS trước khi sự cố xảy ra
Đây là mục bạn có thể dùng ngay hôm nay — gửi cho hỗ trợ, hoặc tra trong tài liệu.
1. "Bảo trì có kèm khởi động lại máy không?" Câu hỏi quan trọng nhất. Nó quyết định bạn có cần cấu hình tự chạy lại hay không.
2. "Địa chỉ IP có đổi sau khi khởi động lại không?" Nếu có, bạn cần biết để xử lý việc sàn chặn IP. Nếu nhà cung cấp cho IP tĩnh, hãy dùng — nó loại bỏ hoàn toàn một loại sự cố.
3. "Có trang trạng thái công khai không, và tôi có thể đăng ký nhận thông báo không?" Đăng ký nhận thông báo là việc 2 phút, và nó cho bạn thông tin trước thay vì sau.
4. "Chính sách bồi hoàn khi downtime vượt ngưỡng là gì?" Không phải để đòi tiền — mà để bạn biết mốc nào là bất thường.
5. "Máy của tôi có bản sao lưu tự động không, và tôi có thể phục hồi dữ liệu từ nó như thế nào?" Nhiều nhà cung cấp có dịch vụ này và nhiều khách hàng không biết mình đang có.
Nếu nhà cung cấp không trả lời được những câu này, đó cũng là thông tin — và đó là thông tin nên biết trước khi có sự cố, không phải sau.
6. Câu hỏi thường gặp
Hỏi: Máy khởi động lại lúc 3 giờ sáng, bot tự chạy lại lúc 3 giờ 2 phút. Vậy có sao không?
Có thể vẫn có vấn đề: (a) bot tự chạy lại nhưng kết nối tới sàn chưa được thiết lập lại; (b) AutoTrading chưa bật lại; (c) bot có thể đã gửi lại lệnh cũ. Cách kiểm tra: so giờ tick cuối với giờ hiện tại, kiểm tra trạng thái AutoTrading, và đối chiếu số lệnh đang mở với ghi chép trước khi máy tắt.
Hỏi: Có nên đóng hết lệnh trước mỗi lần bảo trì không?
Không có câu trả lời chung — nhưng phải có câu trả lời trước. Nguyên tắc gợi ý: nếu bảo trì dự kiến dưới 1 giờ và chiến lược của bạn giữ lệnh nhiều ngày, để lệnh lại thường hợp lý hơn. Nếu bảo trì dự kiến vài giờ và bạn không chắc máy lên lại đúng, đóng lệnh an toàn hơn.
Hỏi: Nhà cung cấp báo bảo trì 2 giờ nhưng thực tế mất 6 giờ. Nên làm gì?
Ba việc: (a) ghi lại vào nhật ký, kèm chênh lệch; (b) kiểm tra chính sách bồi hoàn; (c) đánh giá lại xem khoảng cách giữa dự kiến và thực tế có lặp lại không. Nếu lặp lại hai ba lần, đó là thông tin để cân nhắc đổi nhà cung cấp.
Hỏi: Tôi có nên tự động hoá toàn bộ quy trình quanh bảo trì không?
Không cần thiết. Quy trình 20 phút, vài lần một năm — tự động hoá nó tốn công hơn tự làm, và khi tự động hoá sai thì bạn không biết. Hãy chỉ tự động hoá hai việc nhỏ và rõ ràng: tự chạy lại MT5 sau khởi động, và cảnh báo khi máy mất kết nối.
Hỏi: Làm sao biết máy đã lên lại mà không cần vào kiểm tra?
Cần một hệ thống giám sát từ bên ngoài — một máy khác ping tới VPS của bạn định kỳ và báo cho bạn khi không ping được, và báo tiếp khi ping được trở lại. Đây là khoản đầu tư nhỏ và nó trả lời câu hỏi này tự động.
Hỏi: Bảo trì rơi vào giờ giao dịch chính thì sao?
Hai việc: (a) ghi lại và phản hồi với nhà cung cấp — nhiều nhà cung cấp sẽ tránh nếu bạn nêu; (b) đánh giá lại lựa chọn nhà cung cấp, vì bảo trì vào giờ cao điểm của khách hàng là dấu hiệu họ không hiểu nghiệp vụ của bạn.
Hỏi: Có nên dùng hai VPS để phòng bảo trì không?
Với hầu hết người chạy bot cá nhân, không. Chi phí một VPS chạy 24/7 quanh năm thường lớn hơn thiệt hại của vài giờ gián đoạn mỗi lần bảo trì. Cách hợp lý hơn là dùng máy dựng theo giờ, chỉ trả khi thật sự cần — nhưng chỉ khi bạn đã có kịch bản dựng lại và đã thử nó.
Hỏi: Nhà cung cấp báo bảo trì nhưng máy tôi vẫn chạy bình thường. Có phải họ nhầm không?
Không nhất thiết. Nhiều thông báo bảo trì gửi cho toàn bộ khách hàng trong một khu vực, và chỉ một phần máy bị ảnh hưởng. Đừng coi việc máy vẫn chạy là bằng chứng an toàn — hãy làm đủ quy trình, vì chi phí của việc làm là 20 phút, còn chi phí của việc bị ảnh hưởng mà không chuẩn bị là một đêm giao dịch.
7. Checklist và tóm lại
Một lần, làm ngay:
- [ ] Gửi năm câu hỏi ở mục 5 cho nhà cung cấp VPS
- [ ] Đăng ký nhận thông báo bảo trì và thông báo sự cố
- [ ] Lưu địa chỉ trang trạng thái vào nơi bạn dễ thấy
- [ ] Ghi lại IP hiện tại của VPS và tài khoản sàn có giới hạn IP không
- [ ] Kiểm tra máy có bản sao lưu tự động không, và cách phục hồi
- [ ] Viết kịch bản dựng lại VPS (để dùng khi phải chuyển máy)
Trước mỗi lần bảo trì:
- [ ] Quyết định đóng hay để lệnh lại — và ghi quyết định đó ra
- [ ] Ghi lại số lệnh, khối lượng, mức stop-loss của từng lệnh
- [ ] Tắt AutoTrading trước giờ bảo trì 15 phút
- [ ] Tạo ảnh chụp máy nếu có thể, và kiểm tra bản sao ngoài máy
- [ ] Ghi giờ bảo trì theo cả giờ của bạn và giờ sàn
Sau mỗi lần bảo trì:
- [ ] Xác nhận máy đã lên (ping, rồi tới tiến trình, rồi tới nhịp dữ liệu)
- [ ] Kiểm tra kết nối tới sàn, đăng nhập lại tài khoản nếu cần
- [ ] So lại bốn thứ: số lệnh, số chart/EA, bộ tham số, trạng thái AutoTrading
- [ ] Ghi một dòng vào nhật ký: thời lượng dự kiến so với thực tế, có vấn đề gì
Bốn nguyên tắc để nhớ:
- Ba loại gián đoạn cần ba cách chuẩn bị khác nhau. Nhầm loại là sai cách chống.
- "Bảo trì hạ tầng" thường là khởi động lại máy. Và khởi động lại máy nghĩa là bot dừng.
- Ping được máy không có nghĩa là bot đã chạy. Ba bước: ping, tiến trình, nhịp dữ liệu.
- Việc quan trọng nhất sau bảo trì là so lại trạng thái. Đó là cách duy nhất phát hiện bot đã tự mở thêm lệnh trong lúc bạn không nhìn.
Và nếu bạn chỉ làm được một việc sau khi đọc bài này: hãy lưu số điện thoại hoặc kênh hỗ trợ khẩn cấp của nhà cung cấp vào điện thoại. Khi mọi thứ đang sập, việc bạn cần không phải một kênh hỗ trợ chậm — mà là một kênh hỗ trợ nhanh, và bạn đã biết nó ở đâu.